
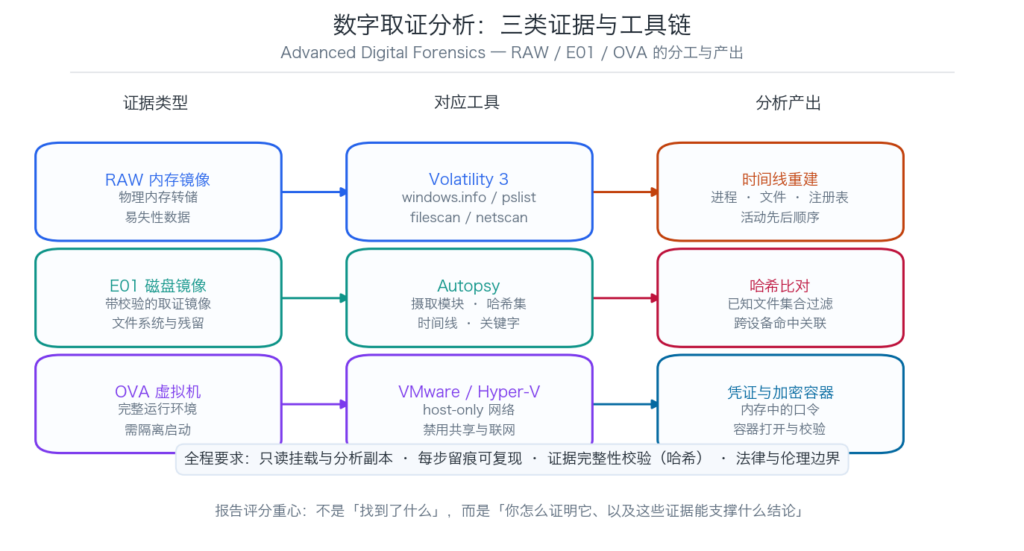
数字取证 代写 这类作业的评分逻辑和普通编程作业完全不同:它不看你「找到了什么」,而看你怎么证明它是它、以及这些证据能支撑什么结论。证据链的严谨性占分远大于发现本身。
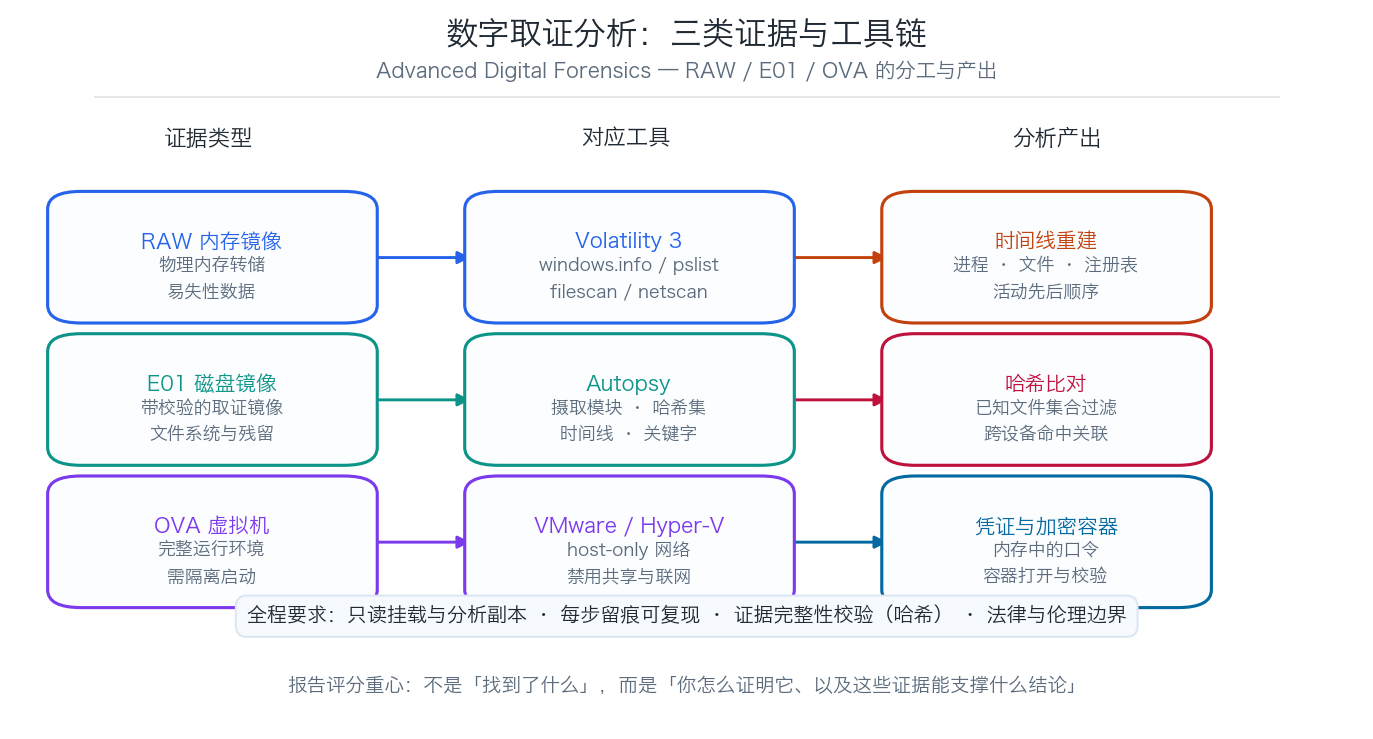
先分清三类证据,工具别用错
多数取证课程的评估包会同时给出三种格式,各自对应不同的分析路径。用错工具是第一步就丢分的地方。
RAW —— 物理内存镜像
内存是易失性数据,包含正在运行的进程、网络连接、加载的驱动、以及明文凭证与解密后的密钥。分析工具用 Volatility 3。
# 先确认镜像的 profile,避免后续插件全部报错
vol -f Memory_Dump.raw windows.info

# 进程列表:找异常进程、父子关系异常
vol -f Memory_Dump.raw windows.pslist
vol -f Memory_Dump.raw windows.pstree

# 命令行参数:恶意软件常在这里暴露
vol -f Memory_Dump.raw windows.cmdline

# 网络连接与监听端口
vol -f Memory_Dump.raw windows.netscan

# 内存中的文件对象(含被删除的)
vol -f Memory_Dump.raw windows.filescan

# 剪贴板内容(有时能捞到口令)
vol -f Memory_Dump.raw windows.clipboard
windows.info 必须第一个跑。Volatility 3 虽然会自动识别,但先确认符号表加载正常,能省掉后面大量莫名其妙的报错。
E01 —— 取证磁盘镜像
E01 是带完整性校验的封装格式(EnCase Image),特点是分段存储 + 每段有 CRC,并且在镜像时可选压缩。分析工具用 Autopsy。
# 命令行侧校验镜像完整性(Autopsy 内部也会做,但报告里要留证据)
ewfverify image.E01
ewfinfo image.E01
Autopsy 的摄取模块(Ingest Modules)要按需开启,不是全开就好——全开会显著拖慢并产生大量无关输出。常用组合:
- Hash Lookup:加载已知文件哈希集,用于快速过滤与命中比对
- File Type Identification:按魔数识别,不信任扩展名
- Keyword Search:关键字检索,注意索引构建耗时
- Timeline:生成时间线,用于活动重建
- EXIF Parser:图片元数据(拍摄设备、时间、GPS)
- Extension Mismatch Detector:扩展名与真实类型不符,常是伪装文件的信号
关键操作原则:Autopsy 必须对镜像副本工作,绝不直接在原始证据上操作。所有分析都在只读语义下进行。
OVA —— 虚拟机镜像
OVA 是完整的运行环境打包(含虚拟磁盘、配置、快照)。它的价值在于可以实际启动系统观察运行时行为——但这里有个必须处理好的安全问题:
- 把网络从 NAT / 桥接改为 host-only,避免被取证系统主动连回外部网络或触发恶意软件的回连
- 关闭共享文件夹、剪贴板共享、拖放
- 导入前先快照,所有操作都在快照上进行,便于回滚
如果环境无法安装该虚拟化软件,可以把 OVA 解包取出虚拟磁盘,再转换成目标平台支持的格式:
# 解包 OVA,取出其中的 VMDK
tar -xvf Device.ova

# 转换磁盘格式(按目标平台选择)
qemu-img convert -O vhdx disk1.vmdk disk1.vhdx     # Hyper-V
qemu-img convert -O vmdk disk1.vmdk disk1-new.vmdk # VMware
哈希比对:最容易被做成「结论」的一步
取证课程几乎必然包含哈希集比对。原理很简单:给定一份已知文件的哈希清单,计算证据中每个文件的哈希,命中的即为同一文件。
import hashlib, csv, os

def sha256_of(path, chunk=1 << 20):
    h = hashlib.sha256()
    with open(path, 'rb') as f:
        for block in iter(lambda: f.read(chunk), b''):
            h.update(block)
    return h.hexdigest()

# 载入已知哈希清单
known = set()
with open('known_hashlist.csv', encoding='utf-8', errors='ignore') as f:
    for row in csv.reader(f):
        for field in row:
            v = field.strip().lower()
            if len(v) in (32, 40, 64):          # MD5 / SHA1 / SHA256
                known.add(v)

# 扫描证据目录
hits = []
for root, _, files in os.walk('evidence'):
    for name in files:
        p = os.path.join(root, name)
        try:
            d = sha256_of(p)
        except OSError:
            continue
        if d in known:
            hits.append((p, d))

for p, d in hits:
print(f'HIT {d} {p}')报告里必须写清楚的三件事,缺一项这一步就白做:
- 哈希算法与来源:用的是哪份清单、清单由谁发布、包含什么类型的文件。
- 哈希值的语义:命中的是内容完全相同的文件,但不能仅凭哈希断言来源、意图或上下文。哈希是同一性判断,不是归因判断。
- 命中之外的排查:未命中不等于无关。要看是否有人重新编码、压缩、分卷,导致内容同一但字节不同。
第 2 点是最常见的失分处——把哈希命中直接写成结论,而忽略了它只证明「这两个文件字节一致」。
跨设备关联:把孤立发现连成叙事
当证据包包含多台设备时,单独分析每台只能得到零散事实。评分看重的是关联能力:
- 哈希交集:同一文件在多台设备上出现 → 传递路径
- 账户与凭证:同一账号、同一口令复用在多台设备出现
- 时间窗对齐:设备 A 的文件创建时间与设备 B 的传输记录是否吻合
- 网络痕迹:邮件发送记录、传输服务的客户端缓存、上传队列残留
把这些做成一张时间线,比堆截图有效得多。
加密容器:口令从哪来
取证场景里遇到加密压缩包是常态。合法路径只有两条:从内存镜像里恢复明文凭证,或者由授权方提供。
# 内存中检索可疑口令字符串,再验证是否可用于打开容器
vol -f Memory_Dump.raw windows.strings --output-file strings.txt

# 验证候选口令(在镜像副本上操作)
7z l -p"$CANDIDATE" container.7z > /dev/null 2>&1 && echo "候选口令有效"报告要说明口令的获取途径与合法性依据,并记录验证过程。这一步同时也是「为什么内存取证不可跳过」的最好论据——全盘加密或加密容器场景下,运行状态是唯一的口令来源。
恶意软件痕迹与网络取证
如果证据中出现远程控制类恶意软件,分析重点在三个层面:
- 驻留痕迹:进程树异常、注册表自启项、计划任务、服务安装。
- 网络迹象:netscan 里的外连地址与端口、DNS 缓存、代理配置、hosts 文件改动。
- 行为时间线:植入时间 → 首次外连 → 数据外传,与其它设备活动对齐。
注意:分析环境必须隔离,不要把样本跑在有外网连接的机器上。
报告结构与评分重心
这类作业通常按学习成果(Learning Outcomes)逐项评分,典型覆盖:取证理论与原则、证据的批判性分析与评价、取证分析流程、法律与伦理要求、取证文献的批判性评估。
对应的报告结构:
- 案情与假设:本案要回答什么问题,范围边界在哪。
- 方法与工具:每类证据用什么工具、版本、为什么选它。
- 发现:分证据类型逐项列出,附命令与输出。
- 分析:把发现连成时间线与因果关系。这一节决定分数高低。
- 局限性:做不到什么、哪些结论证据不足以支撑。
- 法律与伦理:授权范围、数据最小化、证据完整性、个人信息处理边界。
「局限性」一节最容易被跳过,却最能体现分析水平。主动指出自己结论的边界,比宣称一个绝对结论可信得多。
法律与伦理:不是套话,是评分项
取证分析涉及真实数据,课程的这一部分有实质要求:
- 授权范围:只分析评估包明确给你的证据,不越界访问其它系统或数据。
- 数据最小化:只提取与案件问题相关的信息,不做无差别全量检索。
- 完整性保护:全程对副本操作、记录哈希、保留原始证据不动。
- 个人信息处理:报告中避免复述与案情无关的个人数据;截图注意脱敏。
- 可复现性:每个结论都能被第三方按你记录的命令重新得到。
另外,很多课程对生成式 AI 有明确分级限制(例如仅允许拼写与语法检查)。提交前务必核对课程的 AI 使用条款并按要求填写声明——这属于学术诚信范畴,比丢分严重得多。
常见扣分点
- 工具用错:拿磁盘工具处理内存镜像,或反之。
- 直接对原始证据操作,没有使用分析副本。
- 哈希命中被写成结论,忽略其仅证明内容同一性。
- 只罗列发现,没有时间线与关联分析。
- 缺少局限性讨论。
- 法律与伦理章节写成通用套话,未结合本案。
- 命令与输出未记录,结论不可复现。
- 虚拟化环境未隔离,或未关闭共享与网络。
代写Pro 的数字取证服务
- 三类证据分工处理:内存、磁盘、虚拟环境各用对应工具链,不走弯路。
- 结论有证据支撑:区分「证明」与「推测」,不把同一性判断写成归因结论。
- 时间线与关联分析:多设备证据交叉验证,形成完整叙事。
- 合规章节到位:授权范围、数据最小化、完整性保护结合本案具体说明。
- 过程可复现:命令、参数与输出全部记录,附哈希校验值。
需要 数字取证 代写 支持,可以联系我们,或查看 留学生计算机代写服务 与 网络安全代写 方向的案例。