
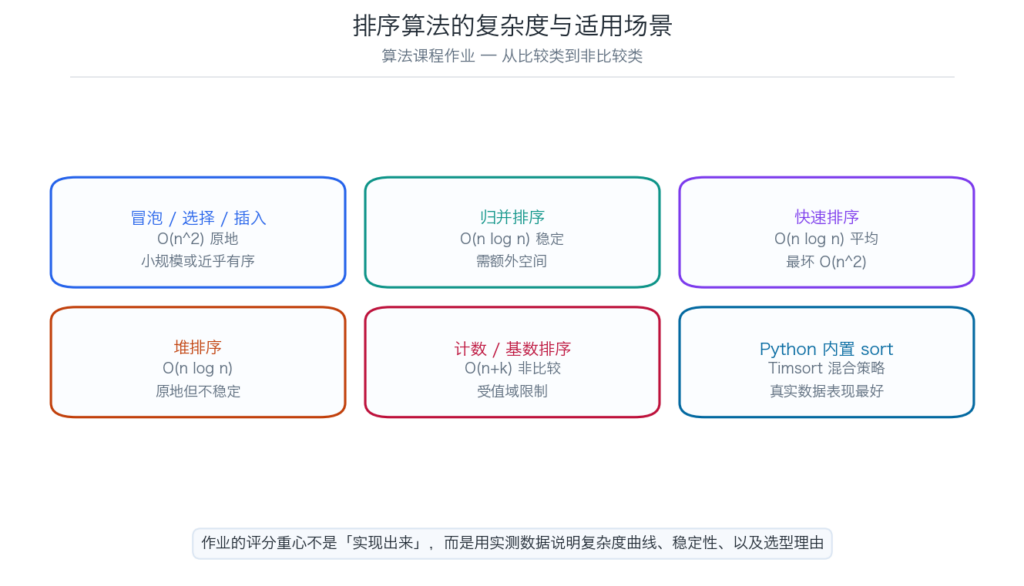
算法作业代写 里,排序算法是最基础的题目,但也是**最容易只拿到及格分**的题目——因为大多数人把算法实现出来就交了,而评分重心其实在实测分析与选型论证上。
实现要点:每个算法都有它的坑
冒泡 / 选择 / 插入排序
三者都是 O(n^2),但实际表现差别很大:
- 冒泡:加一个「本轮是否发生交换」的标志,近乎有序时能提前退出,最好情况降到 O(n)。
- 选择:交换次数最少(n-1 次),但比较次数固定 n(n-1)/2,任何输入都是 O(n^2)。
- 插入:近乎有序时接近 O(n),实践中常作为快速排序小区间的收尾手段。
def insertion_sort(a):
    for i in range(1, len(a)):
        key = a[i]
        j = i - 1
        while j >= 0 and a[j] > key:
            a[j + 1] = a[j]
            j -= 1
        a[j + 1] = key
    return a
归并排序:稳定的代价
def merge_sort(a):
    if len(a) <= 1:
        return a
    mid = len(a) // 2
    left, right = merge_sort(a[:mid]), merge_sort(a[mid:])
    return merge(left, right)

def merge(l, r):
    out, i, j = [], 0, 0
    while i < len(l) and j < len(r):
        # 用 <= 保证稳定性:相等时取左边
        if l[i] <= r[j]:
            out.append(l[i]); i += 1
        else:
            out.append(r[j]); j += 1
    out.extend(l[i:]); out.extend(r[j:])
    return out
稳定性就藏在那一个 <= 里。写成 < 就变成不稳定排序——相等元素会交换相对次序。报告里如果能指出这一点,比只写「归并排序是稳定的」得分高。
快速排序:分区策略决定最坏情况
import random

def quicksort(a, lo=0, hi=None):
    if hi is None:
        hi = len(a) - 1
    if lo >= hi:
        return a
    # 随机选基准,避免已排序输入退化成 O(n^2)
    p = random.randint(lo, hi)
    a[lo], a[p] = a[p], a[lo]
    pivot, i = a[lo], lo
    for j in range(lo + 1, hi + 1):
        if a[j] < pivot:
            i += 1
            a[i], a[j] = a[j], a[i]
    a[lo], a[i] = a[i], a[lo]
    quicksort(a, lo, i - 1)
    quicksort(a, i + 1, hi)
    return a
最坏情况 O(n^2) 出现在每次分区极不均衡时——典型触发条件是已排序或逆序输入配固定基准。随机化基准能把这种情况的概率压到极低,但严格担保还要靠三数取中或 introsort 的堆排序兜底。
实测分析:作业真正的评分点
实现只是起点。报告里应该呈现:
1. 复杂度曲线实测
import time, random
import matplotlib.pyplot as plt

sizes = [100, 200, 400, 800, 1600, 3200]
algos = {
    'insertion': insertion_sort,
    'merge':     merge_sort,
    'quick':     quicksort,
    'builtin':   sorted,
}

results = {name: [] for name in algos}
for n in sizes:
    data = [random.randint(0, 10 * n) for _ in range(n)]
    for name, fn in algos.items():
        t0 = time.perf_counter()
        fn(data.copy())
        results[name].append(time.perf_counter() - t0)

for name, ys in results.items():
    plt.plot(sizes, ys, marker='o', label=name)
plt.xscale('log'); plt.yscale('log')
plt.xlabel('数据规模 n'); plt.ylabel('耗时(秒)')
plt.title('排序算法耗时随规模变化(双对数坐标)')
plt.legend(); plt.grid(alpha=.3)
plt.tight_layout(); plt.savefig('sorting_bench.png', dpi=150)双对数坐标是关键——只有在这个坐标系下,幂律关系才呈现为直线,斜率直接对应复杂度阶数。线性坐标下 O(n^2) 曲线会压扁其它曲线,看不出差异。
2. 输入分布的影响
只测随机输入是不够的。应该至少覆盖四种分布:
- 随机:基准情况
- 已排序:插入排序最快,固定基准快排最慢
- 逆序:插入排序最慢
- 大量重复:三路分区快排才有优势,普通快排退化
把「已排序」和「逆序」两组结果放进报告,能直接支撑「为什么快排需要随机化基准」这个论点。只测随机输入的报告缺一半论证。
3. 稳定性验证
# 用带标记的元组验证稳定性:相同 key 的元素相对次序是否保持
data = [(1, 'a'), (2, 'x'), (1, 'b'), (2, 'y'), (1, 'c')]
key = lambda t: t[0]

stable   = sorted(data, key=key)          # Python 内置:稳定
print(stable)   # [(1,'a'), (1,'b'), (1,'c'), (2,'x'), (2,'y')]

# 自己实现的归并把比较写成 < 而不是 <= 时,'b' 与 'a' 的次序会翻转
用可区分的标记(而不是单纯数字)才能验证稳定性——纯数字列表里「相等元素」无法区分,验证不出任何东西。
选型论证怎么写
作业常要求「说明什么场景下用哪种排序」。合格的论证要把算法特性和场景约束对应起来:
- 小规模(n < 50):插入排序。常数因子小,理论复杂度还没起作用。
- 需要稳定 + 有额外空间:归并排序。也是外部排序的首选。
- 通用场景:快速排序或内置 Timsort。实际数据往往部分有序,Timsort 的混合策略占优。
- 空间受限:堆排序。O(1) 额外空间,代价是不稳定。
- 值域小且为整数:计数排序,O(n+k) 打破比较排序下界。
最后一条可以引出比较排序的 Ω(n log n) 下界——因为 n 个元素有 n! 种排列,每次比较最多提供 1 bit 信息,所以至少要 log2(n!) ≈ n log n 次比较。非比较类排序正是绕开了这个下界。这段论证是常见的加分内容。
常见扣分点
- 只实现算法,没有实测数据。
- 用线性坐标画复杂度曲线,看不出阶数差异。
- 只测随机输入,缺少已排序/逆序/重复值分布。
- 稳定性验证用纯数字列表(无法区分相等元素)。
- 归并排序的比较写成
<,实际不稳定却声称稳定。 - 快速排序固定基准,未讨论最坏情况触发条件。
- 选型论证只列算法名称,不结合场景约束。
- 未提及比较排序的理论下界。
常见问题
算法作业可以用编程语言内置的排序吗?
取决于题目要求。如果题目说「实现排序算法」,那内置函数只能作为对照组出现,不能作为你的实现。我们通常的做法是:手写实现算法,同时在实测部分加入内置 sorted 作为性能上界参照——这样既满足实现要求,也让对比更有说服力。
复杂度实测为什么波动这么大?
三个常见原因:数据规模太小(常数项与噪声主导)、只跑一次(应多次取中位数)、以及 Python 的解释器开销掩盖了算法差异。建议每个规模重复 5 次取中位数,并从 n=1000 起步——小规模下 O(n^2) 和 O(n log n) 的差距还看不出来。
报告需要证明复杂度吗?
如果题目要求「分析复杂度」,不能只贴曲线。曲线是实测验证,理论上还需要给出递推关系与求解过程。例如归并排序的 T(n) = 2T(n/2) + O(n),用主定理得到 O(n log n)。实测与推导互相印证,才算完整的复杂度分析。
原地排序和不原地排序怎么选?
看空间约束。嵌入式或内存受限场景优先原地算法(堆排序、插入排序);一般应用里,归并排序多用的 O(n) 空间通常可接受,换来的是稳定性保证。作业里如果要求论证,把「数据规模上限」和「可用内存」两个数字列出来,结论自然就出来了。
为什么作业要求测多种输入分布?
因为复杂度是关于输入的函数,不是单一数字。同一个快速排序在随机输入下是 O(n log n),在已排序输入下(固定基准)是 O(n^2)。只报一个数字等于隐藏了算法的实际行为。这类要求本质是考察你有没有理解「最好/平均/最坏情况」这三者的区别。
可视化部分需要注意什么?
如果要画排序过程动画或分步图,注意坐标轴含义要标清楚;如果画柱状对比图,规模不同的算法不要放在同一组柱里比较绝对耗时。另外中文标签需要显式指定字体,否则 matplotlib 会渲染成方框。
代写Pro 的算法作业服务
- 实现规范:算法手写实现,稳定性与原地性如实标注并可验证。
- 实测完整:四种输入分布 × 多规模,重复取中位数,双对数坐标呈现。
- 论证到位:复杂度递推推导 + 实测曲线互相印证,选型结合场景约束。
- 可视化规范:坐标轴、图例、中文标签、导出图片全部处理妥当。
需要 算法作业代写 支持,可以联系我们,或查看 Python 编程代写 与 编程作业代写 的服务说明。