
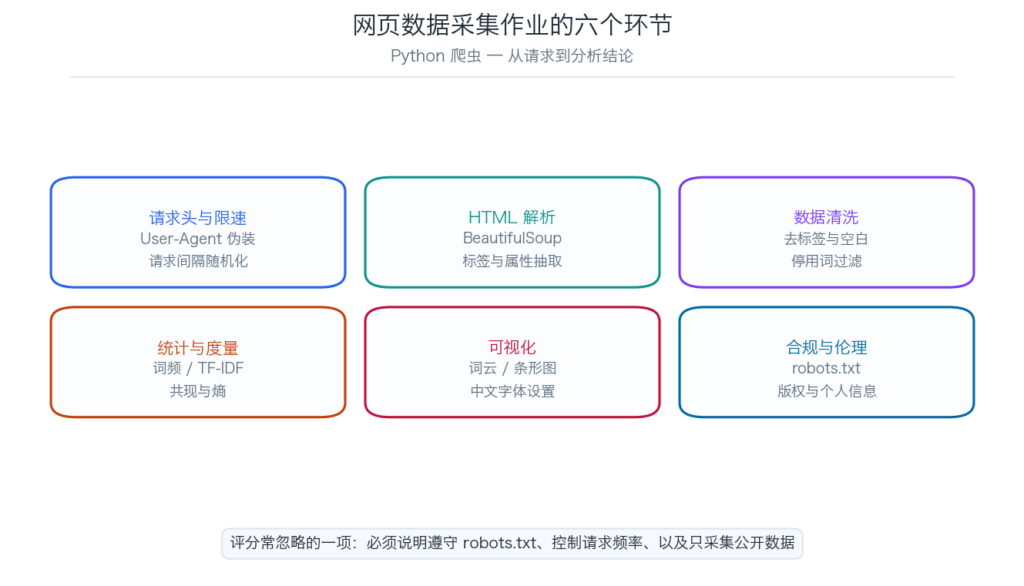
Python 爬虫作业代写 这类题目有个特点:代码写出来不难,但评分表里往往有一栏是「合规与伦理」——遵守 robots.txt、控制请求频率、只采集公开数据。这一栏不写就白丢分。
第一层:请求要有礼貌
import requests, time, random
from urllib.robotparser import RobotFileParser

HEADERS = {
    'User-Agent': ('Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) '
                   'AppleWebKit/537.36 (KHTML, like Gecko) '
                   'Chrome/120.0.0.0 Safari/537.36'),
    'Accept-Language': 'zh-CN,zh;q=0.9,en;q=0.8',
}

def allowed(url):
    """先查 robots.txt,不给自己和对方添麻烦"""
    rp = RobotFileParser()
    rp.set_url(url.split('/')[0] + '//' + url.split('/')[2] + '/robots.txt')
    try:
        rp.read()
        return rp.can_fetch(HEADERS['User-Agent'], url)
    except Exception:
        return False

def polite_get(url, retries=3):
    for i in range(retries):
        if not allowed(url):
            raise PermissionError(f'robots.txt 不允许抓取: {url}')
        try:
            r = requests.get(url, headers=HEADERS, timeout=10)
            r.raise_for_status()
            r.encoding = r.apparent_encoding   # 中文页面编码修正
            # 随机间隔,避免形成规律性高频请求
            time.sleep(random.uniform(1.0, 2.5))
            return r
        except requests.RequestException as e:
            if i == retries - 1:
                raise
            time.sleep(2 ** i)                     # 指数退避
    return None
三个细节经常被忽略但很重要:
r.encoding = r.apparent_encoding——不写这句,中文页面可能按 ISO-8859-1 解码,结果是乱码。raise_for_status()——不写的话 404 页面也会被当成正常内容解析,抽出一堆导航文字。- 随机间隔而非固定间隔——固定间隔的规律性请求对服务器更不友好,也更容易被识别为爬虫。
第二层:解析与抽取
from bs4 import BeautifulSoup

def extract_text(html, selector=None):
    soup = BeautifulSoup(html, 'html.parser')

    # 先剔除脚本、样式、导航等噪声
    for tag in soup(['script', 'style', 'nav', 'footer', 'header', 'aside']):
        tag.decompose()

    # 正文区域定位:优先语义标签,其次指定选择器
    main = soup.find('article') or soup.find('main')
        or (soup.select_one(selector) if selector else None) or soup.body

    return main.get_text(separator=' ', strip=True) if main else ''
先 decompose() 再取文本是顺序关键。先取文本再过滤,会把脚本里的 JS 代码混进语料——词频统计里出现 function、var 这类词就是这个原因。
清洗流水线
import re
from collections import Counter

STOPWORDS = set('的 了 和 是 在 有 我 你 他 她 它 这 那 就 都 而 及 与 或 一个 我们'.split())

def tokenize(text, stopwords=STOPWORDS, min_len=2):
    # 中文:按非中文字符切分,保留长度 ≥ min_len 的词
    tokens = re.findall(r'[u4e00-u9fa5]+|[A-Za-z]{2,}', text)
    out = []
    for t in tokens:
        if re.fullmatch(r'[u4e00-u9fa5]+', t):
            # 中文整句切分后进一步做 2-gram,弥补无分词器的情况
            if len(t) == 1:
                continue
            out.extend(t[i:i+2] for i in range(len(t) - 1))
        else:
            lt = t.lower()
            if lt not in stopwords:
                out.append(lt)
    return out

text = extract_text(html)
words = tokenize(text)
print(Counter(words).most_common(20))如果课程允许用第三方库,jieba 分词比 2-gram 准确得多。作业里如果没限制,用它并在报告里说明选择理由——2-gram 会产生大量无意义组合词,这是它的已知局限。
第三层:度量与可视化
词频之外,还应该算什么
只报词频是及格线。能拉开分数的是:
- TF-IDF:抑制在所有文档中都出现的常见词,凸显某篇的特征词
- 词汇丰富度:type-token ratio(不同词数 / 总词数)
- 共现关系:同一窗口内共同出现的词对,反映主题聚集
- 熵:词频分布的香农熵,衡量用词的集中或分散程度
import math
from collections import Counter

def shannon_entropy(words):
    c = Counter(words); n = sum(c.values())
    return -sum((v / n) * math.log2(v / n) for v in c.values())

def tfidf(docs_tokens):
    df = Counter()
    for toks in docs_tokens:
        df.update(set(toks))
    N = len(docs_tokens)
    out = []
    for toks in docs_tokens:
        tf = Counter(toks); total = sum(tf.values()) or 1
        out.append({w: (cnt / total) * math.log((N + 1) / (df[w] + 1))
                    for w, cnt in tf.items()})
    return out
中文可视化的字体坑
import matplotlib.pyplot as plt

# 指定支持中文的字体,否则标签全是方框
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Hiragino Sans GB',
                                   'Arial Unicode MS', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False   # 负号也要处理

fig, ax = plt.subplots(figsize=(9, 5))
top = Counter(words).most_common(15)
ax.barh([w for w, _ in top][::-1], [c for _, c in top][::-1])
ax.set_xlabel('出现次数'); ax.set_title('高频词 TOP 15')
plt.tight_layout(); plt.savefig('word_freq.png', dpi=150)横向条形图比词云更有信息量——词云好看但读者无法比较具体数量。如果题目要求词云,可以作为补充而非替代。
第四层:合规与伦理(常设独立评分栏)
这一栏最容易被跳过,却在多个课程里单独占分。报告里应明确写出:
- robots.txt 检查:代码中如何实现,抓取前的检查结果。
- 请求频率控制:间隔设置与理由,是否在非高峰时段采集。
- 数据范围:只采集公开页面,不触碰需登录区域。
- 个人信息处理:若采集内容含用户名等标识,说明如何脱敏或排除。
- 版权与引用:说明数据来源,注明仅用于课程分析。
- 不做的事:不绕过反爬机制、不伪造身份、不对目标站点造成压力。
把这些写成具体做法而不是套话——「设置了 1.0–2.5 秒随机间隔」比「我们注意控制频率」有说服力得多。
常见扣分点
- 没有 robots.txt 检查,或检查了但没写进报告。
- 请求间隔固定或过短,未做限速。
- 忘记设置编码,中文全是乱码。
- 未剔除 script/style 标签,语料混入 JS 代码。
- 只用词频,没有 TF-IDF 或多文档对比。
- 图表中文标签渲染成方框。
- 语料规模过小(几百字)无法支撑任何结论。
- 合规与伦理部分缺失或写成通用套话。
- 代码中没有异常处理与重试,网络波动导致采集半途失败。
常见问题
爬虫作业抓哪些网站比较合适?
优先选结构清晰、允许抓取的公开站点:新闻网站的栏目页、公开的统计数据页面、维基类站点的条目页。避免抓取需要登录、有明确反爬声明、或内容涉及个人隐私的站点。作业评分看的是方法完整性,不是数据有多大。
采不到数据怎么办?
三种常见情况:一是目标站点结构变了,选择器失效——需要重新定位;二是被限流,应加大间隔并加指数退避;三是页面内容由 JavaScript 动态渲染,requests 拿到的 HTML 里没有数据。第三种需要用 Selenium 或 Playwright 这类浏览器自动化工具,或者在报告里说明这一限制并改用可静态抓取的源。
需要分布式爬虫吗?
课程作业几乎不需要。分布式带来调度、去重、代理池等一整套复杂度,而作业的评分点在于解析质量与分析深度,不在采集速度。把单机版本做扎实,比搭一个跑不稳的分布式加分更多。
中文分词一定要用 jieba 吗?
如果课程允许第三方库,用 jieba;如果要求只用标准库,2-gram 是最常见的替代方案。两者结果差异明显——2-gram 会产生「的时」「时候」这类无意义组合,需要在报告里说明这一局限,并说明停用词表如何处理。
词云用什么库?
wordcloud 库最常用,但中文需要额外指定字体文件路径,否则全是方框。另外中文词云还依赖分词结果的质量——分词错了,词云会把「的是」「了的」画得很大,看起来很不专业。建议词云与条形图一起给。
报告需要写多少字?
这类作业通常没有硬性字数,但评分表一般按「代码完整性 / 分析深度 / 可视化 / 合规伦理」分栏。分析深度这一栏基本取决于你有没有从描述统计走到推断或对比(例如不同栏目之间的用词差异)。只给一张词频表很难拿满这一栏。
代写Pro 的 Python 爬虫作业服务
- 合规完整:robots.txt 检查、随机限速、指数退避、数据范围说明全部落实并写入报告。
- 解析稳健:噪声标签剔除、编码修正、异常重试,不会采一半崩掉。
- 分析有层次:从词频到 TF-IDF、词汇丰富度、共现与熵,不止描述统计。
- 可视化规范:中文字体处理妥当,图表信息量优先于视觉效果。
- 可复现:请求头、间隔参数、随机种子全部固定,附采集日志。
需要 Python 爬虫作业代写 支持,可以联系我们,或查看 Python 编程代写 与 数据分析作业代写 的服务说明。