
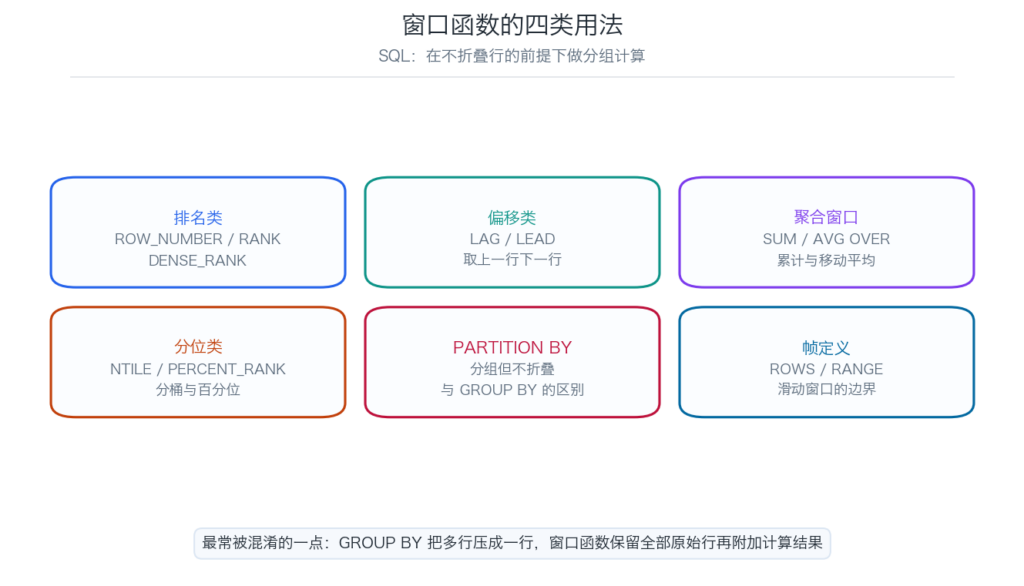
窗口函数是在不折叠原始行的前提下做分组计算。它与 GROUP BY 的根本区别是:GROUP BY 把多行压成一行,窗口函数保留全部原始行,再把计算结果附加到每一行上。
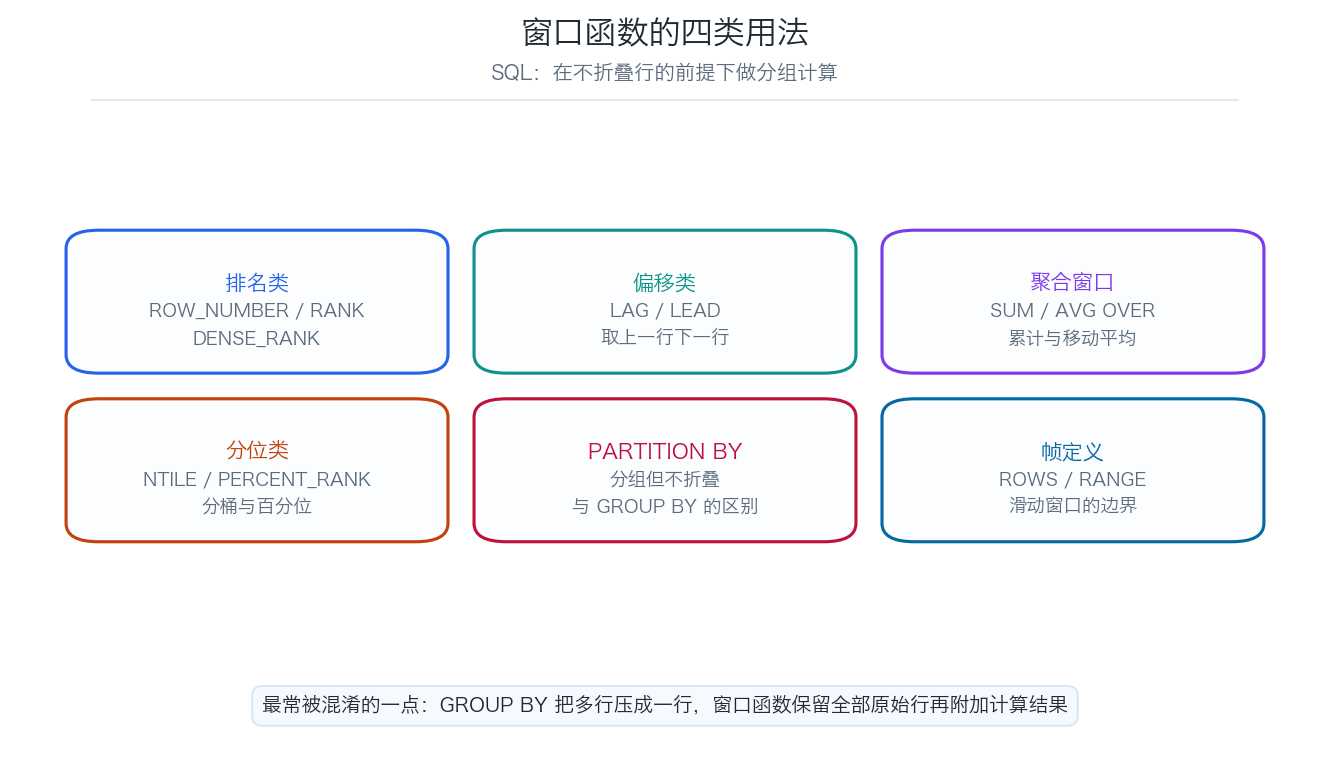
GROUP BY 与窗口函数的区别
GROUP BY 输出的是聚合后的行,窗口函数输出的是原始行 + 计算列。
-- GROUP BY:每个部门一行,看不到具体员工
SELECT dept, AVG(salary) AS avg_salary
FROM employee
GROUP BY dept;

-- 窗口函数:每个员工一行,同时带上部门平均
SELECT name, dept, salary,
       AVG(salary) OVER (PARTITION BY dept) AS dept_avg
FROM employee;这个能力解决了一类此前必须靠自连接或子查询才能解决的问题:把聚合值与原行放在一起比较——「每个员工的薪资与部门平均差多少」。
第一类:排名函数
三个排名函数的差别只在「遇到并列时怎么办」:ROW_NUMBER 不并列、RANK 并列后跳号、DENSE_RANK 并列后不跳号。
SELECT name, score,
       ROW_NUMBER() OVER (ORDER BY score DESC) AS row_no,
       RANK()       OVER (ORDER BY score DESC) AS rnk,
       DENSE_RANK() OVER (ORDER BY score DESC) AS dense_rnk
FROM student;
假设分数为 100, 95, 95, 90:
| score | ROW_NUMBER | RANK | DENSE_RANK |
|---|---|---|---|
| 100 | 1 | 1 | 1 |
| 95 | 2 | 2 | 2 |
| 95 | 3 | 2 | 2 |
| 90 | 4 | 4 | 3 |
「取每门课前 3 名」用哪个?用 RANK 能保留并列第三名(返回 4 行);用 ROW_NUMBER 会强制截断到恰好 3 行,但并列者谁入选是任意的。选择取决于业务是否接受「并列同分却被排除」。
第二类:取前后行(LAG / LEAD)
LAG 取当前行之前第 N 行的值,LEAD 取之后第 N 行,用于计算环比、同比、间隔。
SELECT month, revenue,
       LAG(revenue, 1)  OVER (ORDER BY month) AS prev_month,
       revenue - LAG(revenue, 1) OVER (ORDER BY month) AS mom_change,
       LEAD(revenue, 1) OVER (ORDER BY month) AS next_month
FROM monthly_revenue;
第一行没有「上一行」,所以 LAG 返回 NULL——计算增长率时要处理这个 NULL,否则整个计算会变成 NULL。
-- 环比增长率,首行用 NULLIF 避免除零
SELECT month, revenue,
       ROUND(
         (revenue - LAG(revenue) OVER (ORDER BY month))::numeric
         / NULLIF(LAG(revenue) OVER (ORDER BY month), 0) * 100, 2
       ) AS mom_pct
FROM monthly_revenue;
第三类:聚合窗口(累计与移动平均)
在 OVER 里加 ORDER BY 会定义「帧」,默认是从第一行到当前行——这正好是累计求和。
SELECT day, amount,
       -- 累计求和:默认帧 RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
       SUM(amount) OVER (ORDER BY day) AS running_total,

       -- 7 日移动平均:显式指定帧
       AVG(amount) OVER (
         ORDER BY day
         ROWS BETWEEN 6 PRECEDING AND CURRENT ROW
       ) AS ma7
FROM daily_sales;
不写 ORDER BY 的聚合窗口是「整组聚合」,写了的才是「累计」。这个差别极易遗漏:
SUM(x) OVER (PARTITION BY dept)                     -- 部门总额(每行相同)
SUM(x) OVER (PARTITION BY dept ORDER BY day)        -- 部门内累计
SUM(x) OVER (PARTITION BY dept ORDER BY day
             ROWS BETWEEN UNBOUNDED PRECEDING
                      AND UNBOUNDED FOLLOWING)      -- 又是部门总额
第四类:分桶与百分位
NTILE 把结果按顺序分成 N 桶,PERCENT_RANK 给出相对位置,CUME_DIST 给出累积分布。
SELECT name, score,
       NTILE(4)   OVER (ORDER BY score DESC) AS quartile,
       PERCENT_RANK() OVER (ORDER BY score DESC) AS pct_rank,
       CUME_DIST()    OVER (ORDER BY score DESC) AS cum_dist
FROM student;
NTILE 常用于分层抽样——按某个指标分成四组,每组抽同样数量,保证样本覆盖全部分布区间。
PARTITION BY:分组的边界
PARTITION BY 定义「在哪个范围内排名 / 累计」,不影响输出行数。
-- 每门课程内排名,而不是全表排名
SELECT student_id, course_id, score,
       RANK() OVER (PARTITION BY course_id ORDER BY score DESC) AS rnk_in_course
FROM enrollment;

-- 多个分区键
SELECT region, product, month, sales,
       SUM(sales) OVER (PARTITION BY region, product ORDER BY month) AS running
FROM sales_fact;
帧定义:ROWS 与 RANGE 的区别
ROWS 按物理行数计算边界,RANGE 按排序值计算——在存在并列值时两者结果不同。
-- ROWS:严格取前 2 行 + 当前行
SUM(x) OVER (ORDER BY day ROWS BETWEEN 2 PRECEDING AND CURRENT ROW)

-- RANGE:取「值在当前值减 2 以内」的所有行,并列值会一并包含
SUM(x) OVER (ORDER BY day RANGE BETWEEN 2 PRECEDING AND CURRENT ROW)
做移动平均时通常用 ROWS(想要「最近 N 条记录」),做日期区间汇总时用 RANGE(想要「最近 N 天」)。
执行顺序与常见限制
窗口函数在 WHERE / GROUP BY / HAVING 之后、ORDER BY 之前执行,所以不能写在 WHERE 里。
-- ❌ 错误:窗口函数不能出现在 WHERE 中
SELECT * FROM (
  SELECT name, RANK() OVER (ORDER BY score DESC) AS rnk FROM student
) t WHERE rnk <= 3;   -- 这里 rnk 是子查询的输出列,可以筛选

-- ✅ 正确:用子查询或 CTE 包一层
WITH ranked AS (
  SELECT name, score, RANK() OVER (ORDER BY score DESC) AS rnk FROM student
)
SELECT * FROM ranked WHERE rnk <= 3;
常见错误
- 把窗口函数写在 WHERE 里(应包一层子查询)。
- 以为 ROW_NUMBER 会自动处理并列(它不会,顺序任意)。
- 忘记 ORDER BY 却期待累计求和。
- LAG 首行 NULL 未处理,导致增长率整列为空。
- 移动平均没指定帧,结果与预期不同。
- PARTITION BY 写错,变成全表排名。
- 在 GROUP BY 查询里误用窗口函数(两者作用层级不同)。
- MySQL 8.0 以下不支持窗口函数(需用自连接模拟)。
常见问题
窗口函数和 GROUP BY 能一起用吗?
可以,但要注意顺序:GROUP BY 先聚合,窗口函数在聚合结果上再计算。例如「先按部门汇总总额,再给部门总额排名」——外层用窗口函数,内层用 GROUP BY。
MySQL 5.7 没有窗口函数怎么办?
用变量或自连接模拟排名:SELECT a.*, (SELECT COUNT(*) FROM t b WHERE b.score > a.score) + 1 AS rnk FROM t a。这种写法在数据量大时很慢,能升级到 8.0 就升级。
RANK 和 DENSE_RANK 到底该用哪个?
看业务是否允许「名次跳跃」。评奖通常用 RANK(两个并列第二,下一个是第四);分级(如 ABC 三档)用 DENSE_RANK(两个第二,下一个是第三)。
为什么我的窗口函数结果和预期不一样?
三个高频原因:忘了 ORDER BY(导致默认整组聚合而不是累计)、PARTITION BY 写错(分组范围不对)、帧定义默认是 RANGE 而不是 ROWS(并列值处理不同)。逐项检查这三点。
窗口函数性能怎么样?
通常比等价的子查询快,因为它只需一次扫描。但 PARTITION BY 涉及排序,数据量大时要注意是否有对应索引。用 EXPLAIN 看执行计划里有没有额外的 sort 步骤。
可以在窗口函数里用 DISTINCT 吗?
大多数数据库不支持 COUNT(DISTINCT x) OVER (...)。变通做法是先按分区键去重再计数,或用 DENSE_RANK 等技巧模拟。PostgreSQL 支持部分场景,需查对应版本文档。
想搞懂 SQL 的执行顺序?
窗口函数能不能用、写在哪里,取决于 SQL 的执行顺序(FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY)。如果你对这条链路还不清楚,可以看看学习辅导——用具体的查询例子讲清楚每一步发生了什么。