
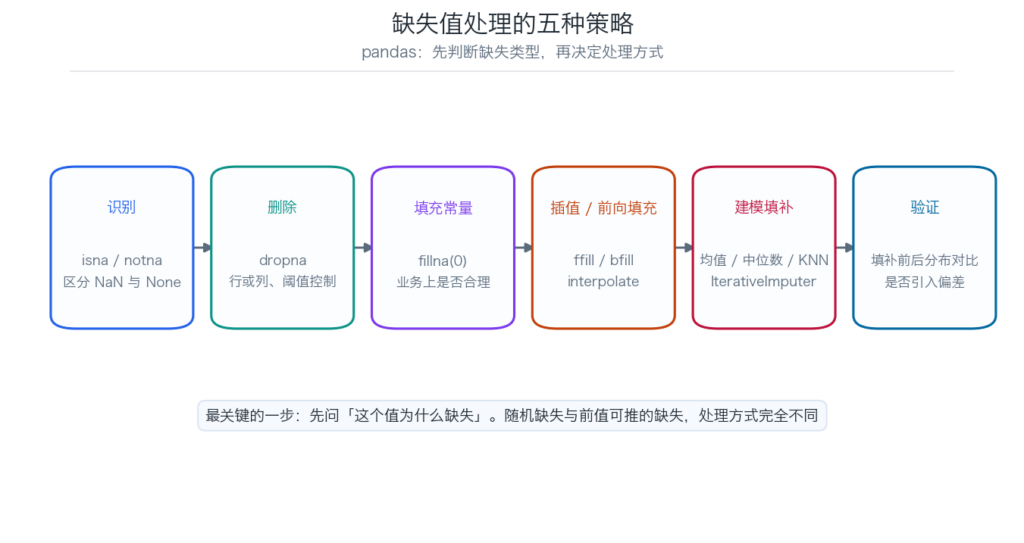
缺失值处理的第一步不是选方法,而是问「这个值为什么缺失」。随机缺失、可从其它字段推断的缺失、以及本身就有含义的缺失,正确的处理方式完全不同。
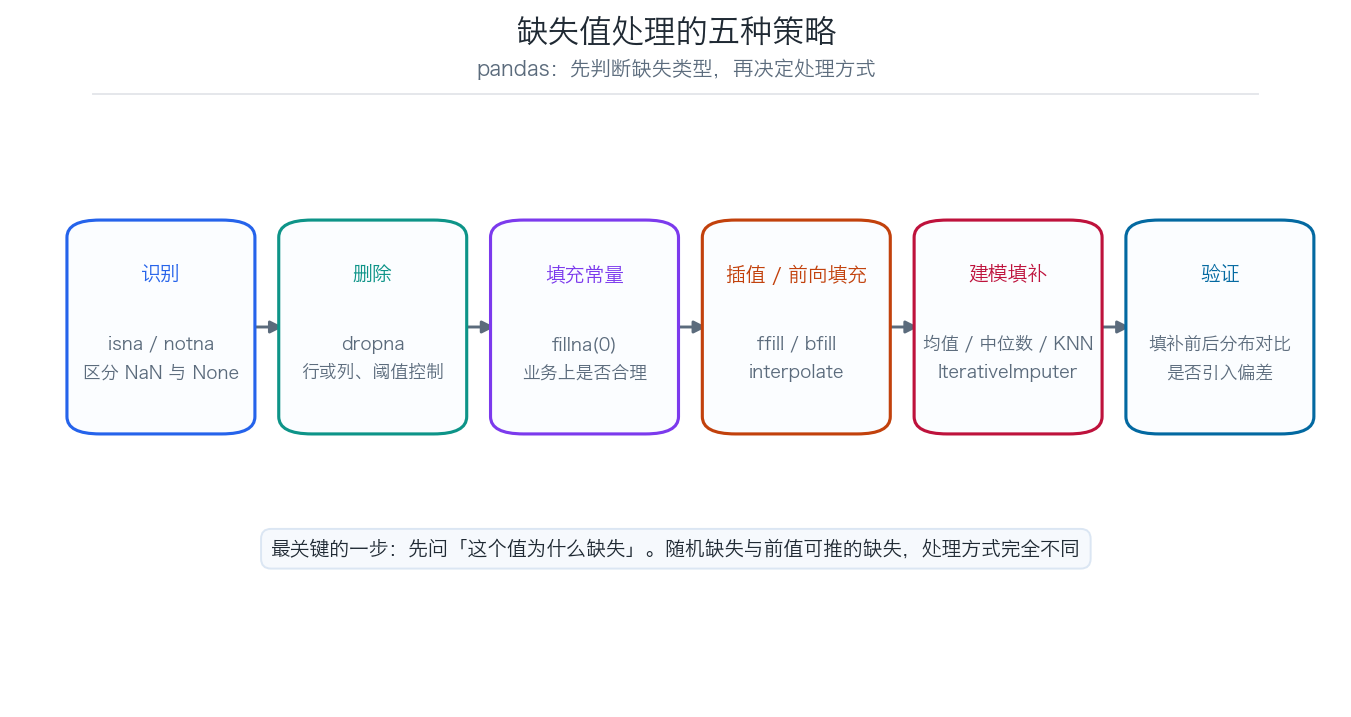
先识别:NaN、None、空字符串不是一回事
pandas 里 NaN 是浮点缺失标记,None 是 Python 对象缺失,空字符串是完全不同的东西——前者会被 isna 识别,后者不会。
import pandas as pd
import numpy as np

df.isna().sum()          # 各列缺失数量
df.isna().mean()         # 缺失比例

# 常见坑:字符串列里的空串或占位符,isna 检测不到
df['city'].replace({'': np.nan, 'N/A': np.nan, '未知': np.nan}, inplace=True)

# 数值列的哨兵值(如 -1 表示缺失)
df['age'] = df['age'].replace(-1, np.nan)统计缺失比例是第一步判断依据:某列缺失超过 60%,通常直接考虑删列而不是填补。
缺失机制:决定方法的关键
统计上把缺失分三类:完全随机缺失(MCAR)、随机缺失(MAR)、非随机缺失(MNAR)——只有前两类能用常规方法处理。
- MCAR(完全随机):缺失与任何变量无关。例如仪器偶发故障。删除不会引入偏差。
- MAR(随机缺失):缺失与其它已观测变量相关。例如收入缺失与年龄相关。可以用其它变量建模填补。
- MNAR(非随机):缺失与缺失值本身相关。例如高收入者更不愿填收入。任何常规填补都会有偏,必须在报告中说明这一局限。
怎么判断?做一个简单的检验:把「是否缺失」当作标签,看它与其他变量是否相关。
# 检查缺失是否与其他变量相关(MAR 的迹象)
df['is_missing'] = df['income'].isna()
print(df.groupby('is_missing')['age'].mean())
print(df.groupby('is_missing')['education'].value_counts(normalize=True))
如果两组差异明显,说明缺失不是完全随机的——直接删除会引入偏差。
策略一:删除
删除适用于缺失比例低且为 MCAR 的情况,是成本最低但最容易引入偏差的方法。
# 删除含缺失的行
df.dropna()

# 只在这些列上看缺失
df.dropna(subset=['income', 'age'])

# 删除缺失超过 50% 的列
df.dropna(axis=1, thresh=len(df) * 0.5)

# 至少要有 80% 非缺失才保留该行
df.dropna(thresh=len(df.columns) * 0.8)要报告删掉了多少行。如果删掉 30% 的样本,结论的可推广性已经变了,这一点必须写进报告。
策略二:常量填充
填充固定值只在「缺失本身有业务含义」时合理,否则会扭曲分布。
df['coupon_used'] = df['coupon_used'].fillna(0)      # ✅ 没记录通常意味着没用
df['price'] = df['price'].fillna(0)                   # ❌ 价格缺失填 0 会拉低均值

# 更安全的做法:另加一列标记是否填补
df['price_filled'] = df['price'].isna()
df['price'] = df['price'].fillna(df['price'].median())加标记列是个好习惯——它让后续分析可以检验「填补是否影响结论」。
策略三:前向填充与插值
时序数据优先考虑 ffill / bfill / interpolate,因为它们利用了数据的时间顺序信息。
# 时间序列必须先按时间排序
df = df.sort_values('date')

df['value'] = df['value'].ffill()        # 用上一个有效值填
df['value'] = df['value'].bfill()        # 用下一个有效值填

# 线性插值
df['value'] = df['value'].interpolate(method='linear')

# 时间感知插值(按时间间隔而非行号)
df = df.set_index('date')
df['value'] = df['value'].interpolate(method='time')
ffill 的两个陷阱:一是连续大量缺失时会把同一个值复制很多遍,人为制造「无变化」的假象;二是没排序就 ffill,填的是错误方向的值。
策略四:统计量填补
用均值、中位数、众数填补简单快速,但会人为压缩方差、削弱相关性。
# 中位数:对偏态分布更稳健
df['income'] = df['income'].fillna(df['income'].median())

# 分组填补:利用组内信息,比全表中位数更合理
df['income'] = df.groupby('city')['income'].transform(
    lambda s: s.fillna(s.median())
)

# 众数:类别变量
df['city'] = df['city'].fillna(df['city'].mode()[0])分组填补明显优于全局填补——它保留了组间差异。比如不同城市的收入中位数本来就不同,用全表中位数会抹平这个结构。
策略五:模型填补
用其它变量预测缺失值,适合 MAR 且变量间相关性较强的情况。
from sklearn.experimental import enable_iterative_imputer  # noqa
from sklearn.impute import IterativeImputer, KNNImputer

# KNN 填补:用最相似的 K 个样本的值
knn_imp = KNNImputer(n_neighbors=5)
df[['age', 'income', 'score']] = knn_imp.fit_transform(df[['age', 'income', 'score']])

# 迭代填补:把每列当作目标,用其它列预测,反复迭代
iter_imp = IterativeImputer(max_iter=10, random_state=42)
df[['age', 'income', 'score']] = iter_imp.fit_transform(df[['age', 'income', 'score']])注意数据泄漏:填补器必须在训练集上 fit,再 transform 测试集。如果在全量数据上 fit,测试集信息就泄漏了。
验证:填补有没有破坏数据
填补后必须检查分布是否被扭曲——这是最容易被跳过、却最能体现严谨性的一步。
import matplotlib.pyplot as plt

fig, axes = plt.subplots(1, 2, figsize=(12, 4))
df.loc[df['price_filled'], 'price'].plot(kind='hist', bins=30, alpha=.6,
                                          ax=axes[0], label='填补值')
df.loc[~df['price_filled'], 'price'].plot(kind='hist', bins=30, alpha=.6,
                                           ax=axes[0], label='原始值')
axes[0].legend(); axes[0].set_title('填补值 vs 原始值分布')

# 相关性的变化
print('填补前相关性:n', df_original.corr())
print('填补后相关性:n', df.corr())
如果填补后某两个变量的相关性从 0.6 涨到 0.9,说明填补引入了人为关联——用同一组变量填补多个列时特别容易发生。
常见错误
- 不区分缺失机制,直接全表 dropna。
- 字符串列的空串或
-1哨兵值没被识别为缺失。 - 时序数据没排序就 ffill。
- 用 0 填补价格、收入这类不可能为 0 的字段。
- 全表均值填补而不做分组,抹平组间差异。
- 填补器在划分前 fit,造成数据泄漏。
- 填补后不检查分布与相关性变化。
- 报告里不提填补比例与所用方法。
常见问题
缺失多少比例就该考虑删列?
没有统一阈值,常用经验是超过 60% 且该列不是关键变量时考虑删列。但如果这一列是研究的核心变量(比如你要预测的因变量),缺失 30% 也不能删,而要改用能处理缺失的模型或考虑多重插补。
均值填补和插值有什么区别?
均值填补不考虑顺序,用在时序数据上会把趋势抹平。插值利用相邻点的位置信息,能保留趋势形态。所以时序数据应该用插值或 ffill,而不是均值。
多重插补(MICE)是什么?
它生成多份填补后的数据集,每份的填补值略有不同,分别分析后把结果合并。这样做能反映「填补本身的不确定性」,是统计上最严谨的方法。statsmodels 与 R 的 mice 包都提供实现。代价是流程复杂,通常用于正式研究而非探索性分析。
类别变量怎么填补?
三种做法:众数填补(最简单)、新增「未知」类别(保留缺失信息)、或用其它变量预测(如用城市预测缺失的省份)。新增「未知」类别往往比众数填补更好,因为它不假设缺失值属于已有类别。
填补后模型效果反而变差怎么办?
常见于 MNAR 或填补引入了错误结构。可以试三个方向:改用支持缺失值的模型(XGBoost / LightGBM 原生处理缺失)、加「是否缺失」作为特征、或回到数据源头确认缺失原因。
pandas 的 fillna 提示 future warning 是什么原因?
较新版本的 pandas 对「链式赋值」与就地修改更严格。推荐写成 df['col'] = df['col'].fillna(x),而不是 df['col'].fillna(x, inplace=True)。后者在新版本里可能不生效或告警。
想系统学会数据清洗?
缺失值只是数据清洗的一环,完整的流程还包括异常值、重复值、类型转换、日期解析。如果你在做数据分析作业时卡在某一步,可以看看学习辅导——用你自己的数据讲,比看通用教程有效。