
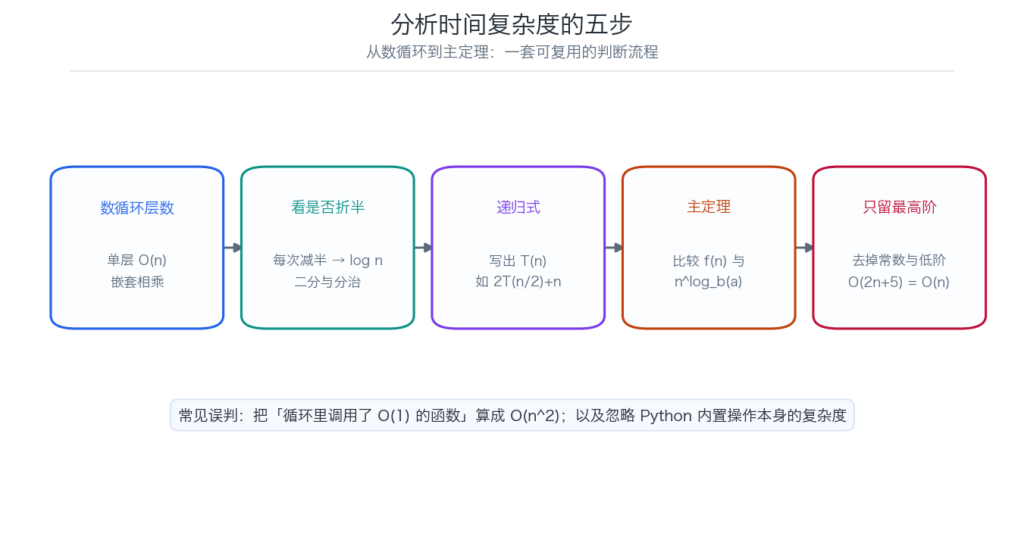
时间复杂度描述的是「运行时间随输入规模增长的趋势」,不是具体秒数。大 O 记号只保留最高阶项并忽略常数,所以 O(2n+5) 写成 O(n)。
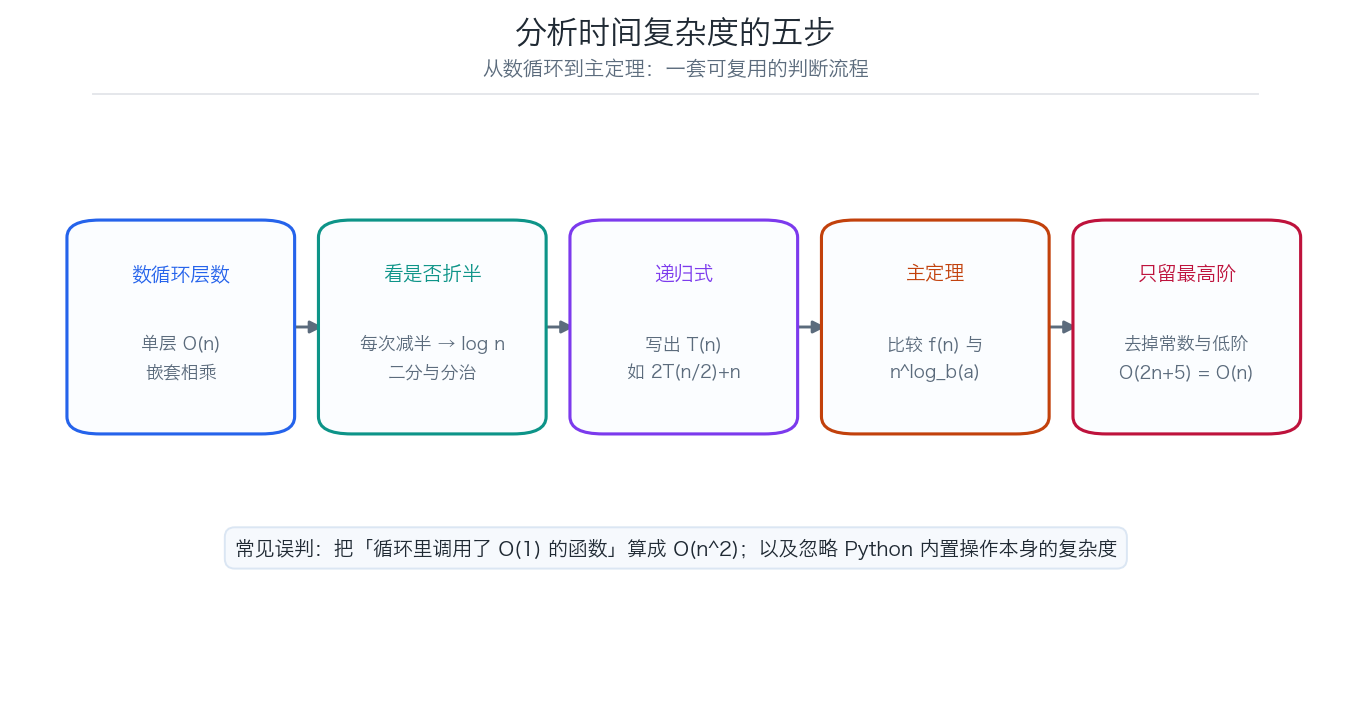
第一步:数循环层数
单层循环遍历 n 个元素是 O(n),两层嵌套相乘得到 O(n^2),但前提是两层都与 n 相关。
# O(n)
for i in range(n):
    do_something()

# O(n^2)
for i in range(n):
    for j in range(n):
        do_something()

# O(n × m) —— 两层规模不同时要分别标注
for i in range(n):
    for j in range(m):
        do_something()

# O(n) 而不是 O(n^2) —— 内层与外层无关
for i in range(n):
    for j in range(10):     # 固定 10 次,是常数
do_something()最常见的误判:把「循环里调用了 O(1) 的操作」算成更高阶。循环体里的一次赋值、一次比较都是 O(1),不影响阶数。
第二步:识别折半
每次把问题规模减半的循环是 O(log n)——因为要执行 log2(n) 次才减到 1。
# O(log n)
i = n
while i > 1:
    i //= 2

# 二分查找:O(log n)
def binary_search(arr, target):
    lo, hi = 0, len(arr) - 1
    while lo <= hi:
        mid = (lo + hi) // 2
        if arr[mid] == target: return mid
        elif arr[mid] < target: lo = mid + 1
        else: hi = mid - 1
    return -1
外层 O(n) + 内层 O(log n) 的组合是 O(n log n)——归并排序与快速排序的平均情况都是这个形状。
第三步:写出递归式
递归算法要先写出 T(n) 的递推关系,再求解——直接看代码数循环是数不出来的。
归并排序:
  把数组分成两半,各自排序,再合并(合并是 O(n))
  T(n) = 2T(n/2) + O(n)

二分查找:
  每次只递归其中一半
  T(n) = T(n/2) + O(1)

朴素斐波那契:
  T(n) = T(n-1) + T(n-2) + O(1)   → 指数级
第四步:主定理
对形如 T(n) = a·T(n/b) + f(n) 的递归式,比较 f(n) 与 n^(log_b a) 的大小即可定阶。
T(n) = a·T(n/b) + f(n)

令 c = log_b(a),比较 f(n) 与 n^c:

1) f(n) 更小(f(n) = O(n^(c-ε)))      → T(n) = Θ(n^c)      递归占主导
2) 两者同阶(f(n) = Θ(n^c))           → T(n) = Θ(n^c · log n)
3) f(n) 更大(且满足正则条件)          → T(n) = Θ(f(n))     合占主导

实例:
归并排序  T(n)=2T(n/2)+n   a=2,b=2 → c=1,f(n)=n 同阶 → Θ(n log n)
二分查找  T(n)=T(n/2)+1    a=1,b=2 → c=0,f(n)=1 同阶 → Θ(log n)
二叉树遍历 T(n)=2T(n/2)+1 a=2,b=2 → c=1,f(n)=1 更小 → Θ(n)主定理不适用的情况:子问题规模不相等(如 T(n)=T(n/2)+T(n/3)+n)、或 f(n) 不满足正则条件。这时要用递归树或代入法。
第五步:只留最高阶
大 O 只关心增长趋势,所以去掉常数因子与低阶项。
3n^2 + 5n + 7      → O(n^2)
n/2 + 100          → O(n)
2^n + n^100        → O(2^n)      指数远大于多项式
n log n + n        → O(n log n)
注意 n 很小时低阶项可能占主导——这就是为什么插入排序(O(n^2))在小数组上比快速排序(O(n log n))更快,也是为什么工程实现里快排会在小区间切换到插入排序。
常见数据结构的操作复杂度
| 操作 | list | dict / set | 排序数组 |
|---|---|---|---|
| 按索引访问 | O(1) | — | O(1) |
| 查找元素 | O(n) | O(1) 平均 | O(log n) |
| 末尾插入 | O(1) 摊还 | O(1) 平均 | O(n) |
| 头部插入 | O(n) | — | O(n) |
| 删除中间 | O(n) | O(1) 平均 | O(n) |
Python 的 x in list 是 O(n),x in set 是 O(1)——这个差别在循环里会被放大成 O(n^2) vs O(n)。
# O(n^2):每次 in 都线性扫描
for x in a:
    if x in b_list: ...

# O(n):哈希查找
b_set = set(b_list)
for x in a:
    if x in b_set: ...
常见误判
- 把固定次数的内层循环算作 n:
for j in range(10)是 O(1),不是 O(n)。 - 忽略 Python 内置操作的复杂度:
list.insert(0, x)是 O(n),slicing是 O(k)。 - 把字符串拼接当 O(1):Python 的
s += t在循环里可能是 O(n^2),应该用''.join()。 - 只看最坏情况而忽略平均情况:快速排序最坏 O(n^2),但平均 O(n log n)。
- 把空间复杂度漏掉:归并排序时间 O(n log n) 但空间 O(n)。
- 认为 O(n log n) 一定比 O(n^2) 快:小规模时低阶项与常数因子可能反转结论。
常见问题
O(n) 和 Θ(n) 有什么区别?
大 O 是上界(「不超过」),大 Θ 是紧确界(「就是这么多」),大 Ω 是下界(「至少这么多」)。日常说「这个算法是 O(n log n)」通常指的是 Θ,但严格来说 O 只保证上界。
为什么二分查找是 O(log n) 而不是 O(log2 n)?
因为大 O 忽略常数底。log2(n) 与 log10(n) 只差一个常数因子(log10 n = log2 n / log2 10),所以在 O 记号下都写成 O(log n)。
递归一定要用主定理吗?
不一定。主定理只适用于 T(n) = aT(n/b) + f(n) 这种「子问题规模相等」的形式。子问题规模不等时用递归树展开,或直接猜答案再用数学归纳法证明。
空间复杂度怎么算?
算的是「额外」占用的空间,不含输入本身。递归的空间复杂度要算调用栈深度:归并排序递归深度 log n,但每层要分配临时数组,所以总空间是 O(n);快速排序递归深度平均 log n,原地分区,所以是 O(log n)。
实际写代码需要精确算复杂度吗?
多数时候只需判断量级:这层循环会不会让总复杂度从 O(n) 变成 O(n^2)?这个操作在循环里是不是 O(n)?知道量级就够做优化决策,精确的数学推导主要用于算法分析与面试。
为什么同样的 O(n log n),实际速度差很多?
因为大 O 忽略了常数因子与内存访问模式。Timsort 比纯归并快,是因为它利用了真实数据的局部有序性;同样是 O(n log n),缓存友好的实现会明显更快。
想搞懂算法分析?
复杂度分析是算法课的第一道门槛,也是后面所有优化的判断依据。如果你在做算法作业或刷题时卡在「这段代码到底是几阶」,可以看看学习辅导——用你手上的代码逐行分析。