
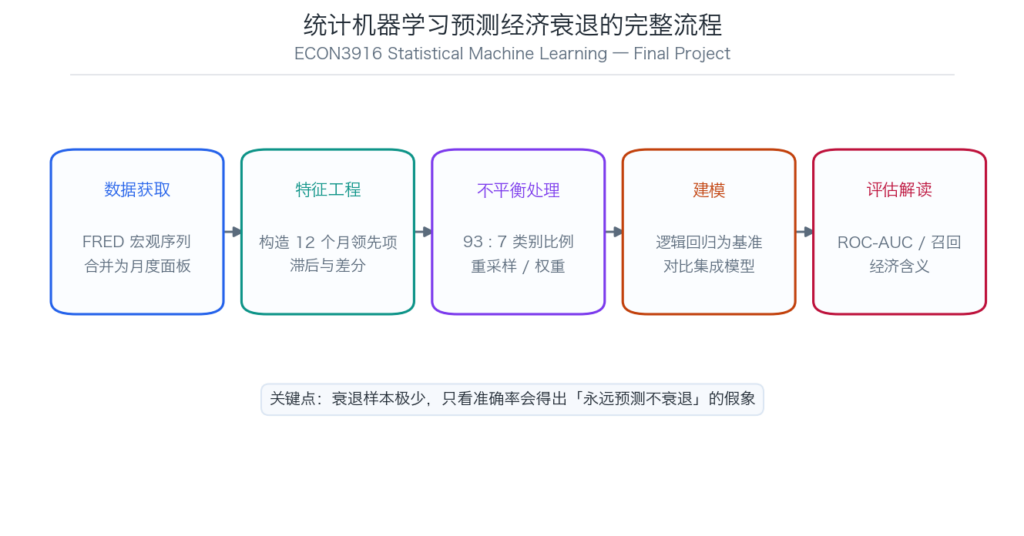
ECON3916 代写 这类「经济学 + 机器学习」的期末项目,难点往往不在模型本身,而在数据构造和指标解释。模型跑通只要十分钟,把结论讲对却要花几天。
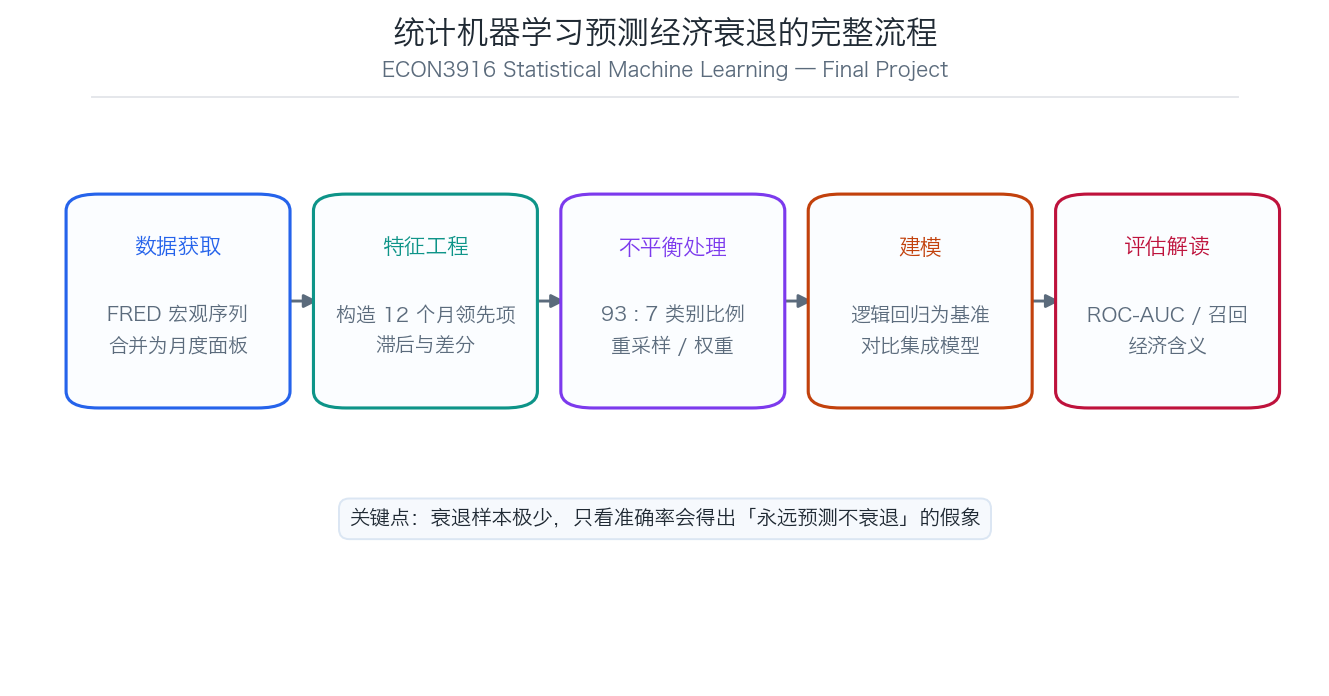
数据层:宏观序列的几个坑
频率对齐
典型做法是从 FRED 拉取几条宏观序列,例如期限利差(T10Y3M)、失业率(UNRATE)、联邦基金利率(FEDFUNDS),再与衰退指标(USREC)合并。问题在于它们的频率未必一致——月度与季度的序列合并时必须明确对齐规则,并说明插值或前向填充的理由。
构造领先项(Lead)
预测目标通常是「12 个月后是否处于衰退」。这意味着标签要向前平移:
df['target'] = df['USREC'].shift(-12)   # 未来 12 个月的衰退状态
df = df.dropna(subset=['target']) # 末尾 12 行无标签,必须丢弃这一步最容易出的错是忘记 dropna,导致训练集里混入空标签;或者平移方向写反,变成用未来预测过去。
类别不平衡:本项目最关键的一点
衰退月份在样本中占比通常只有 7% 左右(93:7)。在这种比例下:
- 一个「永远预测不衰退」的模型准确率就有 93%。
- 只看准确率,你会得到一个看起来很好但毫无用处的模型。
正确的处理方式有两类:
1. 重采样
对少数类过采样(SMOTE)或对多数类欠采样。注意只能在训练集上做——如果在划分前就重采样,测试集会被污染,评估结果虚高。
2. 类别权重 / 代价敏感
model = LogisticRegression(class_weight='balanced', max_iter=1000)
model.fit(X_train, y_train)
class_weight='balanced' 会自动按类别频率反比加权,通常比重采样更稳定,也不需要担心合成样本的合理性。
模型与评估
逻辑回归是这类项目的合理基准——可解释性强,系数方向可以直接对应经济含义。在此基础上可以对比随机森林或梯度提升,但要说明改进是否值得牺牲可解释性。
评估指标应重点报告:
- 召回率:衰退样本被识别出来的比例(经济上最关心)。
- 精确率:预警的假阳性率(决定政策是否愿意采信)。
- ROC-AUC:不受阈值影响的整体区分能力。
常见扣分点
- 未处理类别不平衡,用准确率作为主指标。
- 在划分数据集之前做了过采样,导致数据泄漏。
- 标签平移方向错误或未 dropna。
- 只报告指标数字,不解释其经济含义。
- 没有讨论模型的样本外表现与稳定性。
代写Pro 的 ECON3916 服务
- 数据处理严谨:频率对齐、滞后构造、泄漏检查逐项完成。
- 不平衡处理规范:重采样仅在训练集内进行,或使用类别权重。
- 指标解释到经济含义:把统计指标翻译成政策与市场语言。
- Notebook 可复现:含数据获取步骤与固定随机种子。