
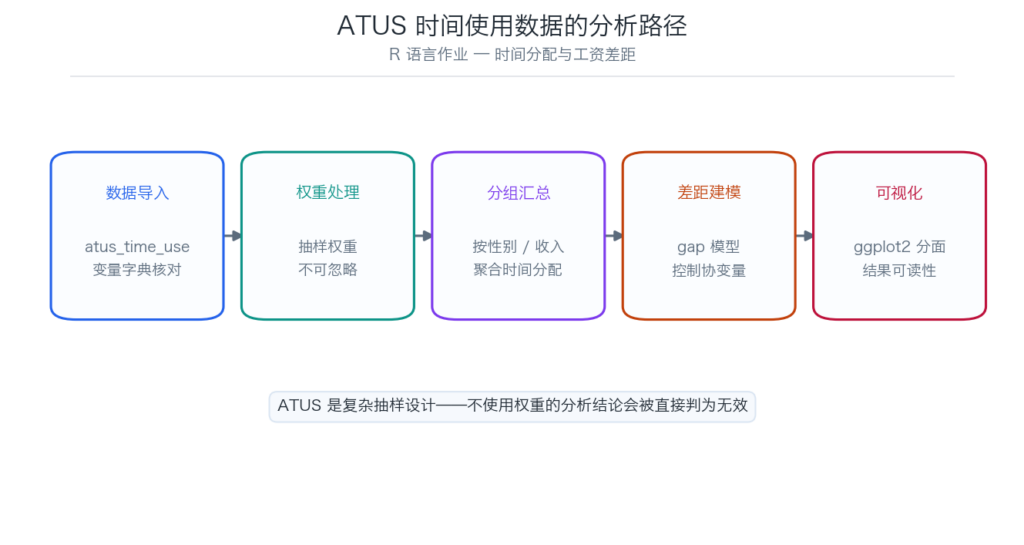
R 语言 数据分析 代写 里,ATUS(American Time Use Survey)是特别容易翻车的数据集——因为它不是简单随机抽样。忽略抽样权重,整份分析的结论在方法上就是无效的。
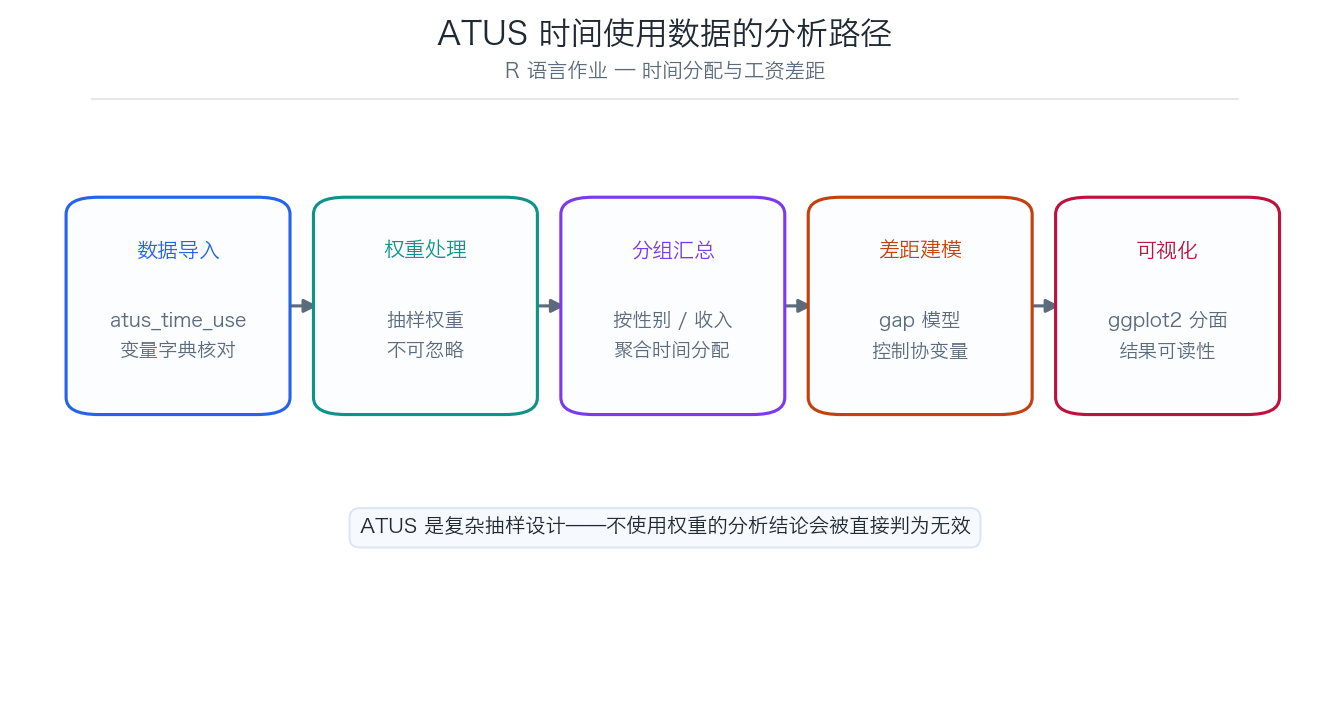
为什么 ATUS 必须用权重
ATUS 采用复杂抽样设计:分层、多阶段、按人口特征加权。每条观测代表的人群数量不同。如果不加权:
- 样本中过度代表的群体(如某些年龄段)会主导结果。
- 计算出的均值不能推断到全国人口。
- 标准误会算错,显著性检验失效。
library(dplyr)

atus <- read.csv("atus_time_use_data.csv")

# 加权均值:不是 mean(x),而是 weighted.mean(x, w)
atus %>%
  summarise(
    avg_work = weighted.mean(work_hours, w = weight, na.rm = TRUE),
    avg_leisure = weighted.mean(leisure_hours, w = weight, na.rm = TRUE)
  )
报告里要明确写出用了哪个权重变量、为什么。常见的权重变量包括个人权重与活动权重,两者的适用场景不同——前者用于个人层面的分析,后者用于时间使用本身的分析。
分组汇总:时间去哪了
atus %>%
  group_by(gender) %>%
  summarise(
    work   = weighted.mean(work_hours,   weight, na.rm = TRUE),
    house  = weighted.mean(housework,    weight, na.rm = TRUE),
    care   = weighted.mean(childcare,    weight, na.rm = TRUE),
    leisure= weighted.mean(leisure_hours,weight, na.rm = TRUE)
  )
按性别、收入分组后,典型发现是:有偿劳动时间的性别差距,小于无偿家务与育儿时间上的差距。这个结论比「女性做家务更多」更有力,因为它同时给出了有偿与无偿两侧的数字。
工资差距建模
「时间分配」常常是解释工资差距的中介变量。建模思路:
model1 <- lm(log(wage) ~ gender, data = atus, weights = weight)
model2 <- lm(log(wage) ~ gender + education + experience + occupation,
             data = atus, weights = weight)
summary(model1); summary(model2)
两个模型对比才有意义:
- model1:不控制协变量的原始差距。
- model2:控制教育、经验、职业后的「剩余」差距。
如果加控制变量后系数大幅下降,说明差距的一部分可由可观测特征解释;如果仍然显著,则说明存在不可观测因素——这句话必须写进结论,它是这类分析的核心价值。
注意:工资通常取对数,因为其分布右偏。直接对原始工资做线性回归会违反残差假设。
ggplot2 可视化要点
library(ggplot2)

p <- atus %>%
  group_by(gender, education) %>%
  summarise(hours = weighted.mean(work_hours, weight, na.rm = TRUE)) %>%
  ggplot(aes(x = education, y = hours, fill = gender)) +
  geom_col(position = "dodge") +
  labs(x = "受教育程度", y = "周均有偿劳动时间(小时)",
       fill = "性别", caption = "数据来源:ATUS|按个人权重加权") +
  theme_minimal()

ggsave("work_gap.png", p, width = 8, height = 5, dpi = 150)
三个细节经常丢分:
- 坐标轴标签带单位。
- 图注写明「按权重加权」,否则读者无法判断方法。
- 字体设置——中文标签需要指定字体族,否则在部分系统上显示为方框。
常见扣分点
- 未使用抽样权重(这类作业最大的失分项)。
- 只做描述统计,没有回归分析。
- 回归不取对数,违反残差假设。
- 模型只跑一个,无法对比控制变量的影响。
- 结论回到因果表述(「教育导致工资上升」),而数据只能支持相关性与条件均值差异。
- 代码未附、或无法复现。
代写Pro 的 R 语言作业服务
- 权重处理正确:按分析层面选择权重变量,方法写入报告。
- 建模有对比:嵌套模型逐步加入控制变量,解释系数变化。
- 结论合规:严格区分相关与因果表述。
- 代码可复现:R 脚本含依赖声明与固定随机种子。