
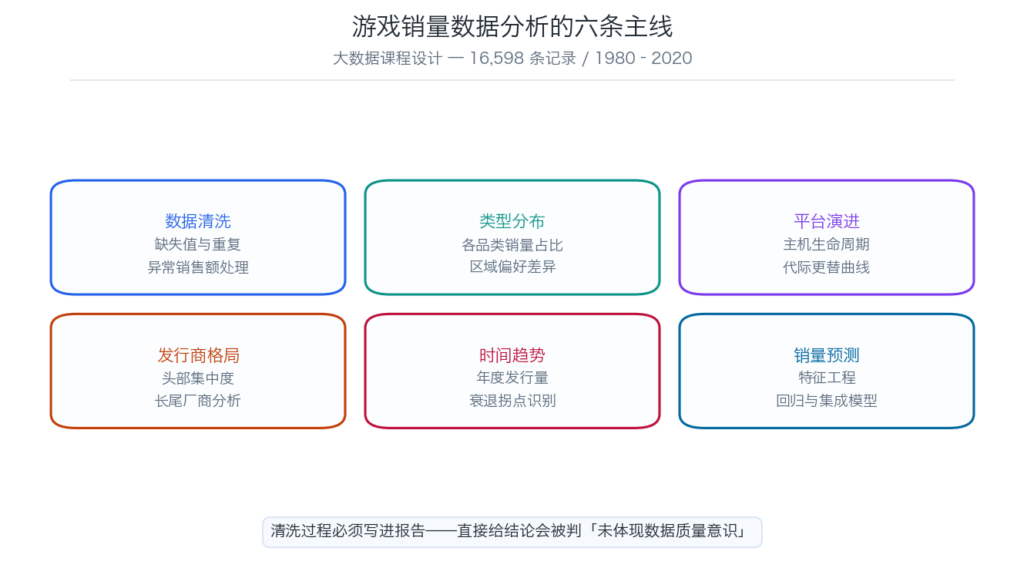
大数据 数据分析 代写 这类课程设计,最容易被低估的环节是数据清洗。很多人拿到 Kaggle 数据集就直接画图,报告里清洗部分只有一句「数据已清洗」——这一项通常占评分表整整一栏。
数据集概况
以经典的 Video Game Sales 数据集为例:
- 约 16,598 条记录,覆盖 1980–2020 年
- 12 种游戏类型(Action、Sports、Shooter、RPG……)
- 31 个平台(NES、Game Boy 到 PS4、Xbox One、Switch)
- 576 家发行商
- 销售额按北美、欧洲、日本、其它地区分列,单位为百万份
数据源自 VGChartz,只收录全球销量超过 10 万份的游戏——这个筛选条件必须写进报告的局限性讨论。
数据清洗:写进报告的部分
import pandas as pd

df = pd.read_csv('vgsales.csv')

# 1. 缺失值
df.isnull().sum()
# Year / Publisher 存在缺失,需说明处理方式:
#   - 年份缺失 → 若占比小且无法推断,直接剔除并在报告中说明
#   - 发行商缺失 → 补为 'Unknown',保留销量记录

# 2. 重复值
df.duplicated(subset=['Name','Platform','Year']).sum()

# 3. 数值异常
df[df['Global_Sales']  2020]                # 超越数据截止年

# 4. 一致性
(df['NA_Sales'] + df['EU_Sales'] + df['JP_Sales']
+ df['Other_Sales'] - df['Global_Sales']).abs().max()最后一条尤其加分:验证区域销量之和是否等于全球销量。如果存在偏差,说明数据本身有口径问题,这属于数据质量发现,写进报告是亮点。
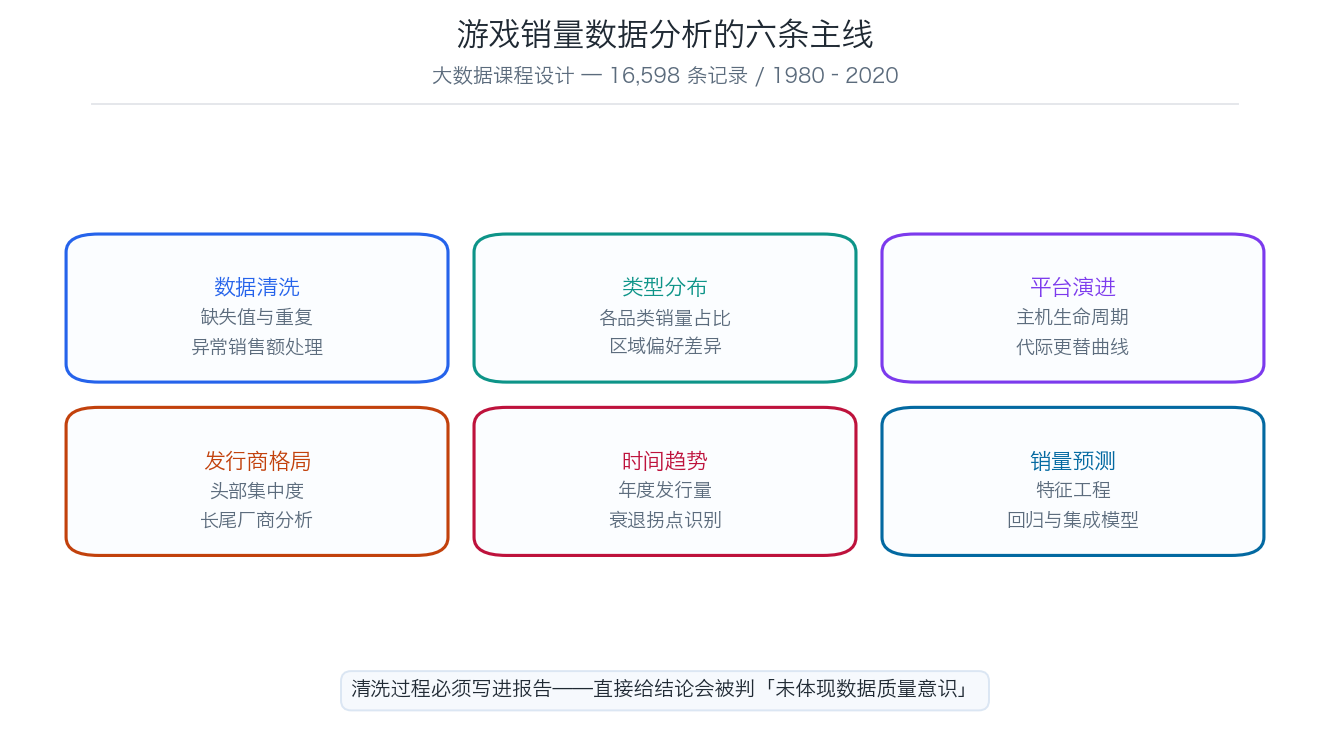
六条分析主线
1. 类型分布与区域偏好
不同区域对游戏类型的偏好差异明显。日本市场对 RPG 的偏好远高于欧美,而欧美市场 Sports 与 Shooter 占比更高。这一差异要落到「为什么」——本土厂商的产品结构、玩家文化、发行渠道。
2. 平台生命周期
platform_years = df.groupby(['Platform','Year'])['Global_Sales'].sum().reset_index()
# 观察每个平台的销量起止年份 → 主机代际更替周期
把各平台的销量曲线画在一起,可以直接看到主机代际更替:PS2 的长尾、Wii 的爆发、Switch 的持续。这是可视化最出彩的一页。
3. 发行商格局与集中度
用 CR4 / CR8(前四/前八名份额)或赫芬达尔指数衡量集中度。头部发行商占多少,长尾有多少家——这能让报告从「描述统计」上升到「市场结构分析」。
4. 时间趋势与拐点
年度发行量在 2008–2010 年前后见顶回落。要讨论原因:移动游戏分流、数字发行未计入、独立游戏崛起、数据源覆盖范围变化。不能只画一条下降曲线就结束。
5. 特征工程
# 目标变量通常是销量,需先决定预测「区域销量」还是「全球销量」
# 类别特征编码
df = pd.get_dummies(df, columns=['Genre','Platform'], drop_first=True)

# 注意:Year 与 Platform 存在强共线性(平台有活跃年份区间)
# 直接同时放入会导致多重共线性,需说明处理方式
6. 预测建模
从线性回归开始做基线,再对比随机森林或梯度提升。评估指标用 RMSE / MAE,并说明为什么不用 R²(销量分布严重右偏)。
关键提醒:销量分布极度长尾,少数爆款占绝大多数销量。直接建模会被离群值主导,通常需要对目标变量取对数,并在报告中说明这一决策。
可视化要点
- 区域对比用分组柱状图或热力图,不用饼图(超过 5 个类别饼图不可读)。
- 时间趋势用折线图,多平台对比时注意配色可区分性。
- 长尾分布用对数坐标,否则头部会压扁其余数据。
- 每张图都要有编号、标题、坐标轴单位与解读文字。
常见扣分点
- 清洗过程不写进报告。
- 只做描述统计,没有建模。
- 建模不处理长尾分布,模型被离群值主导。
- 图表没有编号与解读。
- 不提数据源的局限性(10 万份门槛、数字发行缺失)。
- 结论与前面的分析脱节。
代写Pro 的大数据课程设计服务
- 清洗成章:缺失、重复、异常、一致性四项逐一记录并写入报告。
- 分析有层次:从描述统计到市场结构,再到预测建模。
- 可视化规范:图表类型选择有依据,编号与解读完整。
- 可复现:Notebook 含数据获取步骤与固定随机种子。