
「AI 中的性别偏见」是社科与计算机交叉课程里极常见的 essay 题材。它的问题在于太容易写,也太容易写得平庸——大多数作业都能描述出「AI 有偏见」这个现象,分数差别在于论证链条的完整性。
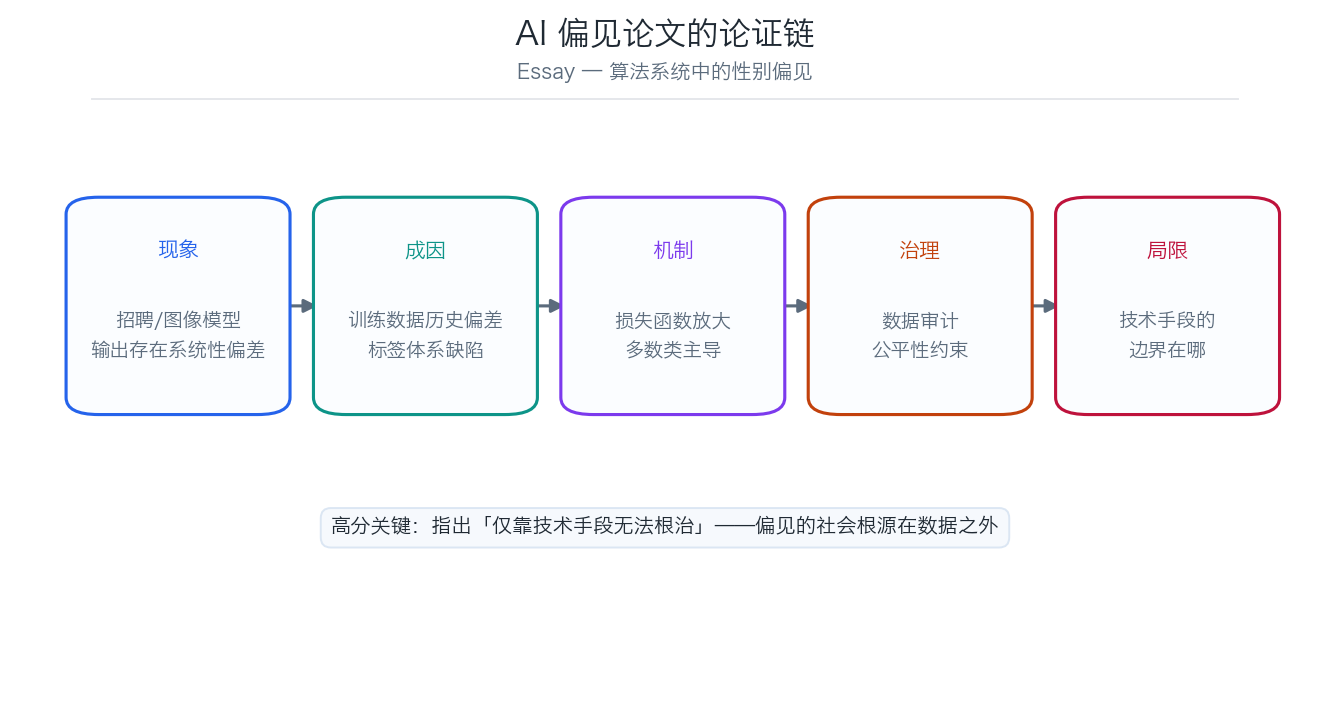
五环论证链
第一环:现象要有具体证据
不要泛泛说「AI 存在性别偏见」。要指向具体系统与具体表现:
- 简历筛选模型对含女性相关词汇的简历降权。
- 图像生成模型把「医生」默认生成男性、「护士」默认生成女性。
- 语音识别对女性音高的识别错误率显著高于男性。
每一条都应有可查证的来源。
第二环:成因分为数据与设计两层
数据层:历史数据本身承载了社会偏见;标注体系沿用既有分类;采样偏差导致某些群体代表性不足。
设计层:目标函数只优化整体准确率,忽略子群体的表现差异;评价指标未做分层统计。
第三环:技术机制——偏见如何被放大
这是区分高分与中档答案的关键。要说明:模型不是「学到了偏见」,而是在优化目标的过程中,把数据中多数类的模式当作通用规律。当少数群体样本稀疏时,模型会把多数类的特征当作默认值——偏见由此被固化并放大。
第四环:治理手段及其适用边界
- 数据侧:重采样、数据增强、代表性审计。
- 模型侧:公平性约束、对抗去偏、后处理校准。
- 流程侧:影响评估、分层指标监控、人工复核环节。
要指出每种手段的代价:公平性约束通常会牺牲部分整体准确率;后处理校准可能导致对某些群体的过度补偿。
第五环:局限——技术手段的边界在哪
这是最容易拿高分的部分。技术去偏只能消除模型层面的差异,无法改变产生这些数据的社会结构。如果招聘市场本身存在系统性歧视,用去偏后的模型继续筛选,只是把偏见隐藏得更深。
常见扣分点
- 只有现象描述,缺少机制分析。
- 把「数据有偏见」当作结论,不再往下推。
- 列举治理手段但不讨论代价与副作用。
- 缺少批判性结论,停在「需要更多研究」。
- 引用二手报道而非原始研究。
代写Pro 的 essay 服务
- 论证链完整:现象 → 成因 → 机制 → 治理 → 局限,逐环推进。
- 机制分析到位:不停留在「数据有偏」的表层。
- 批判性结论:指出技术治理的边界,而非泛泛收尾。
- 引用规范:优先引用原始研究,格式统一。
需要 AI 偏见 Essay 代写 支持,可以联系我们,或了解 留学 Essay 辅导。