
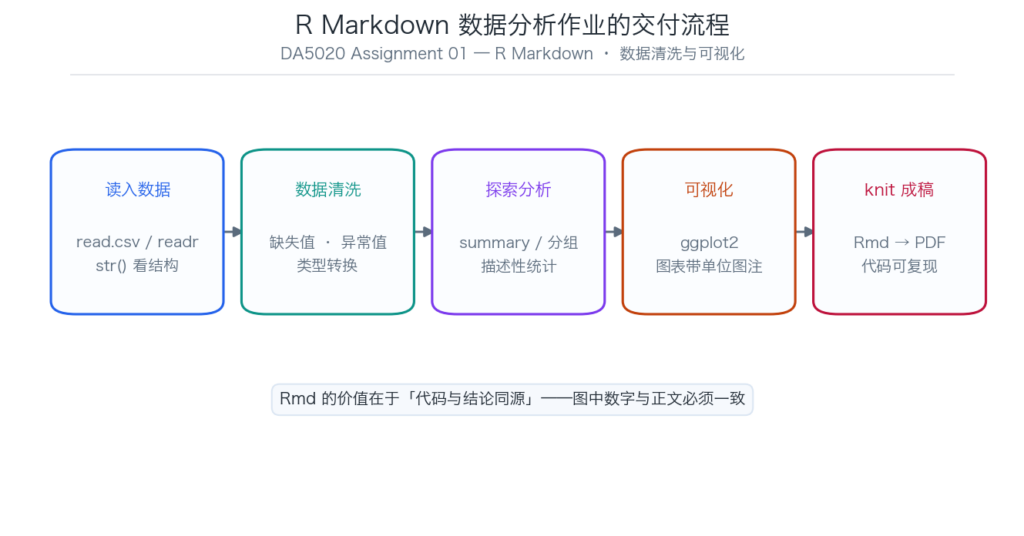
用 R Markdown 交作业的课程,评判标准和交 Word 有本质区别:报告里的每个数字都必须能被代码复现。DA5020 代写 里最常见的失分不是分析做错,而是文中数字与图表对不上。
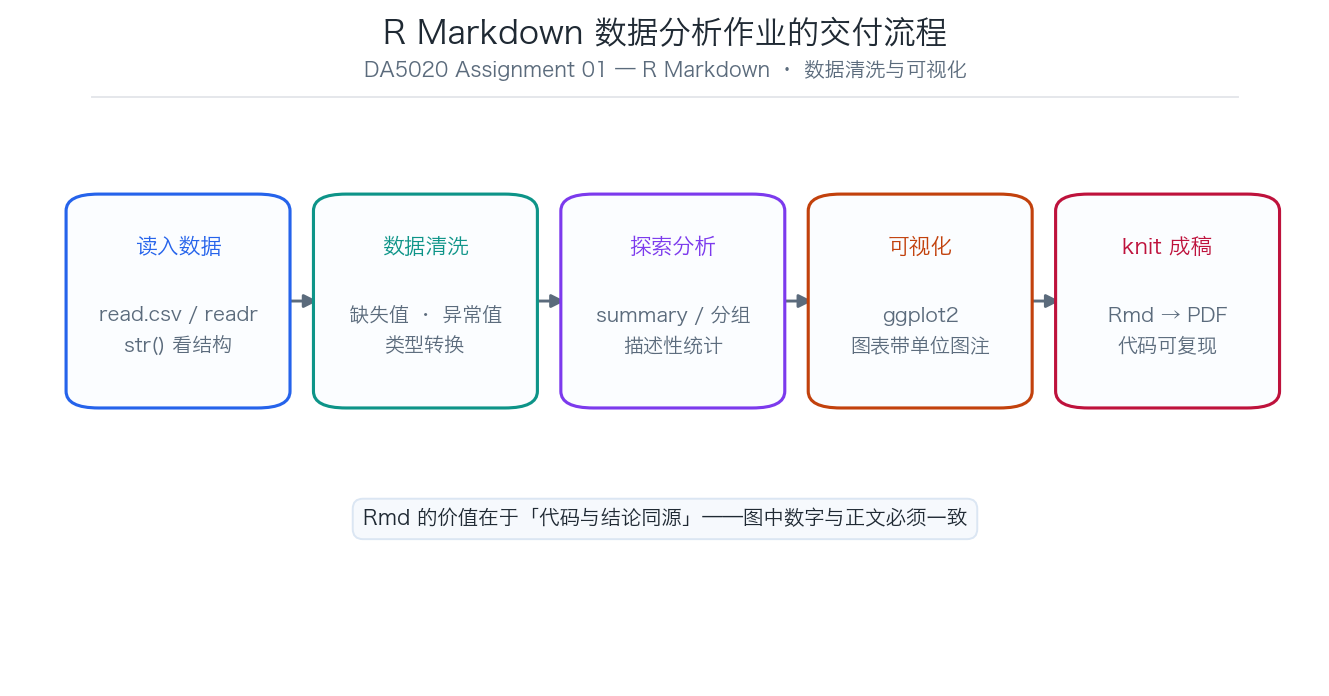
Rmd 的价值:代码与结论同源
knit 生成的文档中,所有统计量都应来自代码块而非手写。常见错误是在正文里手打「共有 768 行数据」,而实际读入的行数因为过滤条件已经变成 392——这类不一致会被直接判定为未验证分析结果。
正确写法是行内 R 代码:
该数据集共有 `r nrow(df)` 行,`r ncol(df)` 个变量。数据清洗:评分最集中的环节
先看结构再动手
df <- read.csv("data.csv", stringsAsFactors = FALSE)
str(df)          # 变量类型是否符合预期
summary(df)      # 分布与异常值线索
colSums(is.na(df))  # 各列缺失情况
把这三步写进报告是有意义的——它证明你的清洗决策基于证据,而不是凭感觉。
缺失值:要说明处理理由
- 删除:适用于缺失比例极低且随机缺失的情况,需说明删了多少行。
- 均值 / 中位数填充:会压缩方差,中位数对偏态分布更稳健。
- 保留为 NA:让后续分析函数显式处理,而不是悄悄填掉。
异常值:区分错误与真实极端值
生理指标出现 0 或负数通常是录入错误,应剔除并记录;而收入分布中的高值可能是真实的长尾,剔除会引入偏差。报告里要写明判断依据。
可视化:图表要能自解释
ggplot2 的图表必须包含:标题、坐标轴单位、必要时的图例与参考线。评分常看这几点:
ggplot(df, aes(x = factor(outcome), fill = factor(outcome))) +
  geom_bar() +
  labs(title = "结局变量分布", x = "结局", y = "样本数") +
theme_minimal()- 坐标轴要有单位或含义,不能只有变量名缩写。
- 类别不平衡时用比例而非计数,避免视觉误导。
- 多图对比时统一坐标轴范围,否则读者无法横向比较。
可复现性
Rmd 的作业通常要求「代码与结果同源」。要做到:
- 文件路径使用相对路径,不放绝对路径。
- 开头设置
set.seed(),涉及随机过程的步骤固定种子。 - 在 setup 块里设置
knitr::opts_chunk$set(echo = TRUE),确保代码可见。 - 依赖包版本在报告或附录中列出。
常见扣分点
- 正文数字与代码输出不一致(手写统计量)。
- 缺失值、异常值未处理直接建模。
- 图表缺标题、单位或图注。
- 使用了绝对路径,换机器无法编译。
- knit 报错却提交了未完整渲染的文档。
代写Pro 的 DA5020 服务
- 行内代码驱动:所有统计量由代码生成,杜绝数字不一致。
- 清洗有依据:每一步处理都写明理由与影响行数。
- 图表规范:标题、单位、图注、参考线齐全。
- 可复现交付:相对路径 + 固定种子 + 依赖清单,换机可编译。