
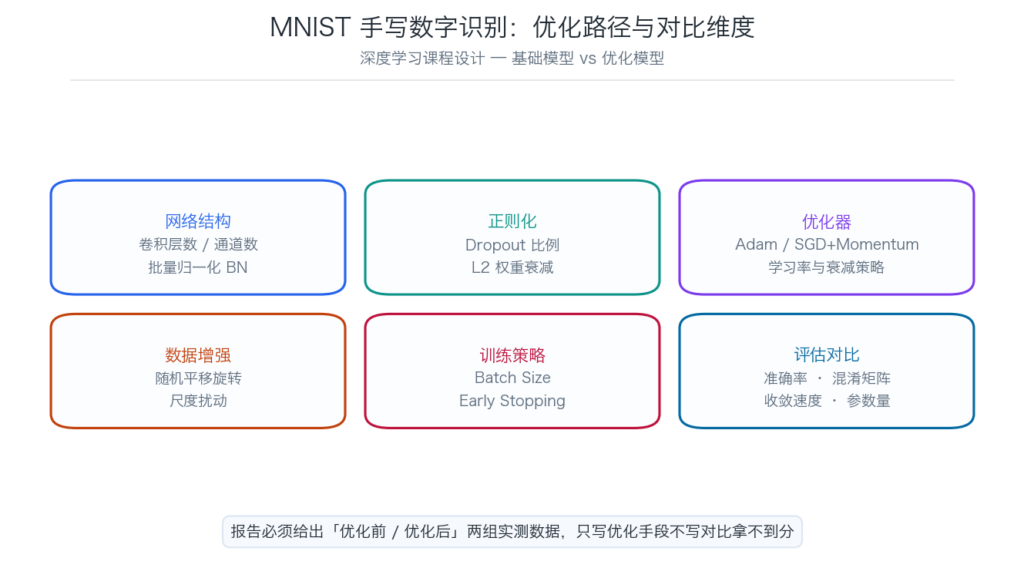
MNIST 手写数字识别 代写 这类课程设计的评分点其实很集中:不是看你模型准确率有多高(MNIST 上 99% 早已不稀奇),而是看优化前后有没有可对比的实测数据,以及能不能解释每个改动为什么有效。
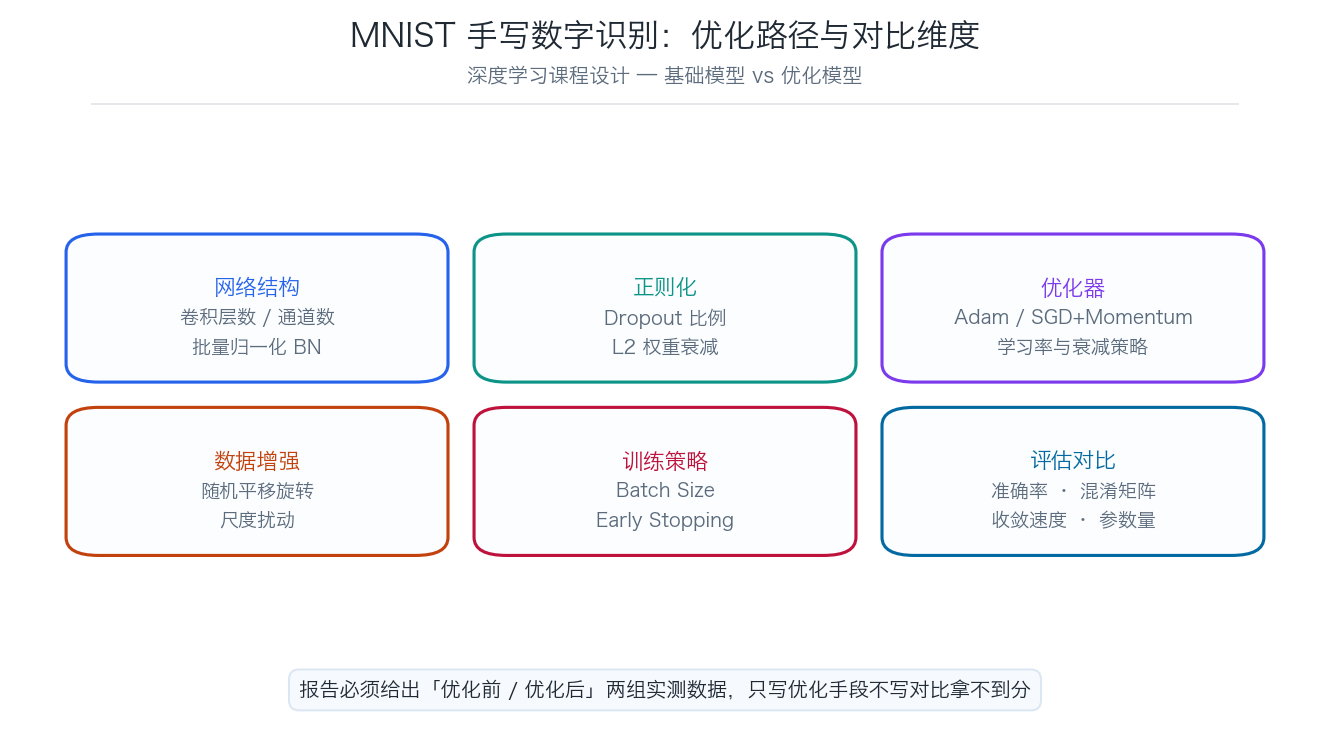
基础模型:先跑通再谈优化
标准做法是两层卷积 + 两层全连接:
model = tf.keras.Sequential([
    tf.keras.layers.Conv2D(32, (3,3), activation='relu', input_shape=(28,28,1)),
    tf.keras.layers.MaxPooling2D((2,2)),
    tf.keras.layers.Conv2D(64, (3,3), activation='relu'),
    tf.keras.layers.MaxPooling2D((2,2)),
    tf.keras.layers.Flatten(),
    tf.keras.layers.Dense(128, activation='relu'),
    tf.keras.layers.Dense(10, activation='softmax'),
])
model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
metrics=['accuracy'])先记录这个模型的参数量、收敛轮数、测试集准确率、混淆矩阵——这四组数字是后面所有对比的基线。没有基线,优化章节无从写起。
优化路径:按性价比排序
1. 批量归一化(最划算)
在卷积层后加 BatchNormalization()。它稳定了每层的输入分布,允许更大的学习率,通常能把收敛轮数砍掉三分之一。改动最小、收益最明显,应该第一个做。
2. Dropout 与正则化
tf.keras.layers.Dropout(0.25),   # 卷积部分
tf.keras.layers.Dropout(0.5),    # 全连接部分
注意 Dropout 比例不是越大越好。全连接层用 0.5、卷积层用 0.25 是经验值。比例设成 0.8 会导致欠拟合,训练集准确率上不去——这种情况要在报告里如实写出并分析原因,比硬凑一个高分更得分。
3. 数据增强
datagen = tf.keras.preprocessing.image.ImageDataGenerator(
    rotation_range=8, width_shift_range=0.08,
    height_shift_range=0.08, zoom_range=0.08)
手写数字本身有书写倾角与位置偏移,小幅增强能提升泛化。但幅度不能大——旋转 30° 的「6」可能看起来像「9」,反而制造错误标签。
4. 学习率与优化器
从 Adam 换成 SGD + Momentum 有时能得到更好的泛化,但需要配学习率衰减。如果报告里要写这一项,务必给出两种优化器的对比曲线,而不是只贴最终准确率。
评估:不要只报准确率
MNIST 类别均衡,准确率是合理指标,但报告里更该呈现:
- 混淆矩阵:看清楚哪些数字互相混淆。常见的是 4/9、3/8、5/6 这几组。
- 错误样本可视化:把预测错的图挑出来展示。写字潦草的样本会说明「模型错得合理」。
- 训练曲线:训练集与验证集准确率的差距能直接反映过拟合程度。
- 参数量与推理耗时:说明优化的代价。
import numpy as np
from sklearn.metrics import confusion_matrix
y_pred = np.argmax(model.predict(x_test), axis=1)
cm = confusion_matrix(y_test, y_pred)
# 找出错误样本
wrong = np.where(y_pred != y_test)[0]
报告结构(3000 字 / 8 部分)
多数课程设计对报告有硬性结构要求:摘要、引言、相关技术、基础模型、优化方案、对比分析、总结与改进方向、参考文献。其中对比分析必须成表:
- 每项优化 → 单独的消融实验(只加这一项,看变化量)
- 全部优化叠加 → 总效果
- 说明哪一项边际收益最高、哪一项几乎无效
只写「我加了 BN、Dropout、数据增强,准确率从 98.2% 提升到 99.1%」是不够的——评审想知道每一项各贡献了多少。
常见扣分点
- 没有基线模型就只展示优化后结果。
- 混淆矩阵只贴图不解读。
- 把测试集用于调参(应划分验证集)。
- 优化手段堆砌但无消融实验。
- 10 张运行截图缺失或没有编号标注。
- 报告字数不足 3000 字。
代写Pro 的深度学习课程设计服务
- 基线 + 消融:每项优化单独验证,给出边际贡献表。
- 代码可直接运行:依赖声明、随机种子固定、路径可配置。
- 报告符合模板:8 部分结构、图表编号、字数达标。
- 截图规范:按要求生成并标注 10 张运行结果图。