
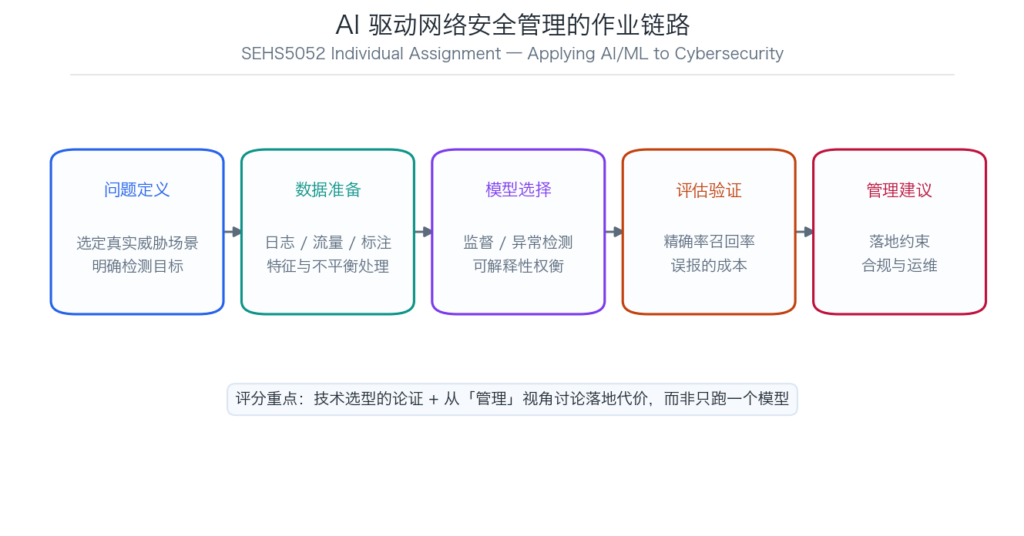
香港理工 SPEED 的 SEHS5052 代写 这类作业有个很特别的地方:它挂在「管理」名下,但要求你真正用 AI/ML 解决一个网络安全问题。两端都要顾到,只做一半就会失分。
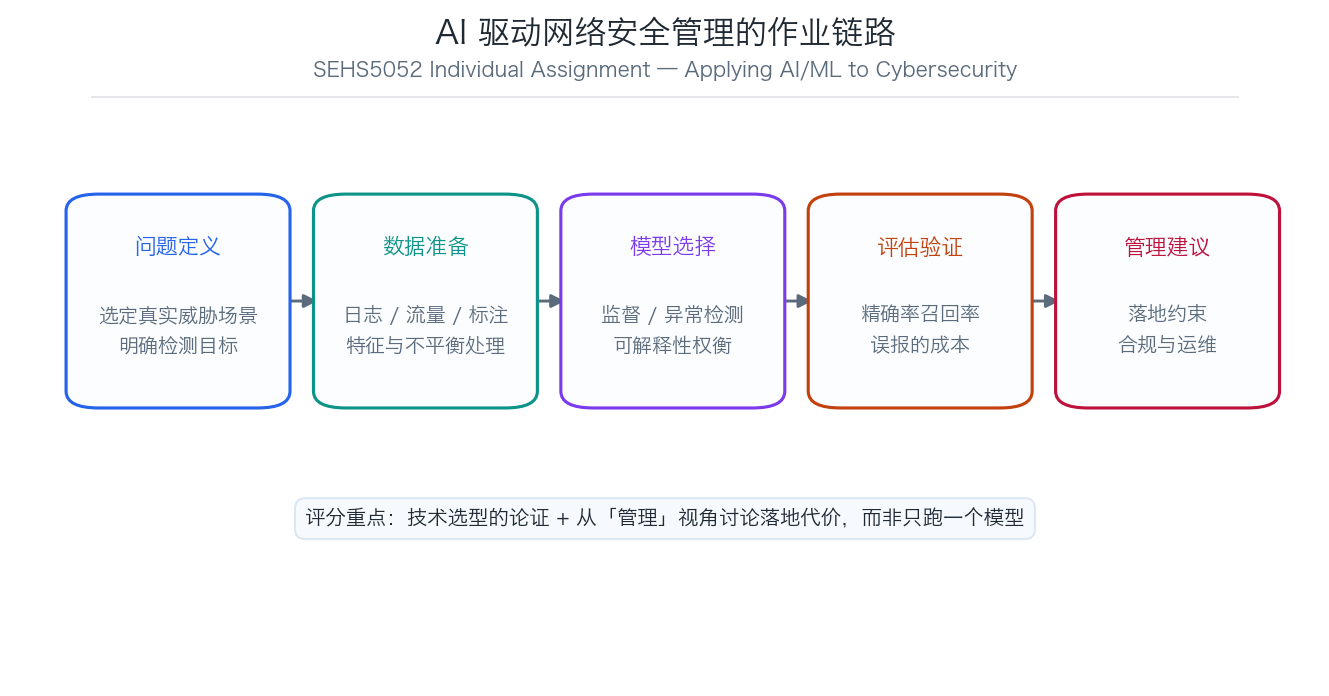
评分拆解:五个必须覆盖的环节
1. 问题定义:先证明这个问题值得用 AI
不要一上来就选模型。要先说明这个安全场景「为什么传统规则引擎搞不定」——例如入侵检测的签名库面对变种流量失效、告警量超出人工处理能力。这一步决定了后面所有技术选择是否站得住。
2. 数据与特征
公开数据集(如 NSL-KDD、UNSW-NB15、CICIDS)是最常见的选择。评分会看你是否处理了:
- 类别不平衡:正常流量远多于攻击流量,直接训练会得到一个「全判正常」的废模型。
- 特征冗余:网络流特征里大量高度相关的字段,需要做筛选或降维。
- 时间泄漏:如果数据集本身按时间排列,随机划分训练集会造成信息泄漏。
3. 模型选型要论证,不要堆砌
很多同学会跑五六个模型然后贴一张对比表。但评分更看重你为什么选它:随机森林在表格型流量特征上表现稳定、可输出特征重要性;深度模型适合原始包序列但对数据量要求高;异常检测方法(如 Isolation Forest)适合无标注场景。
4. 评估指标:别只看准确率
在网络安全的语境下,误报和漏报的代价完全不对称。漏掉一次入侵可能是数据泄露,误报一次只是多一条告警。所以应该重点讨论:
准确率 (Accuracy)      → 不平衡数据下会产生假象
精确率 (Precision)     → 误报率,直接决定运维负担
召回率 (Recall)        → 漏报率,直接决定安全风险
F1 / ROC-AUC           → 综合权衡
5. 管理视角的落地约束
这是 SEHS5052 区别于纯技术课的地方。要讨论:部署在哪一层(端点 / 网关 / SOC)、延迟能接受多少、模型更新频率、谁是最终决策者(自动阻断还是人工确认)、合规与日志留存要求。
常见扣分点
- 只跑模型不写管理建议——直接丢掉这门课一半的分。
- 类别不平衡未处理,用准确率掩盖了模型失效。
- 选型理由是「这个模型很流行」而不是贴合场景。
- 缺少误报成本与运维负担的量化讨论。
代写Pro 的 SEHS5052 服务
- 技术与管理双线交付:模型实现 + 管理建议章节,覆盖评分全部环节。
- 不平衡处理到位:重采样、类别权重、代价敏感学习按场景选择。
- 指标解释规范:解释每个指标在本场景下的实际含义,而不是罗列数字。
- 可复现:固定随机种子,附运行环境与依赖版本。