
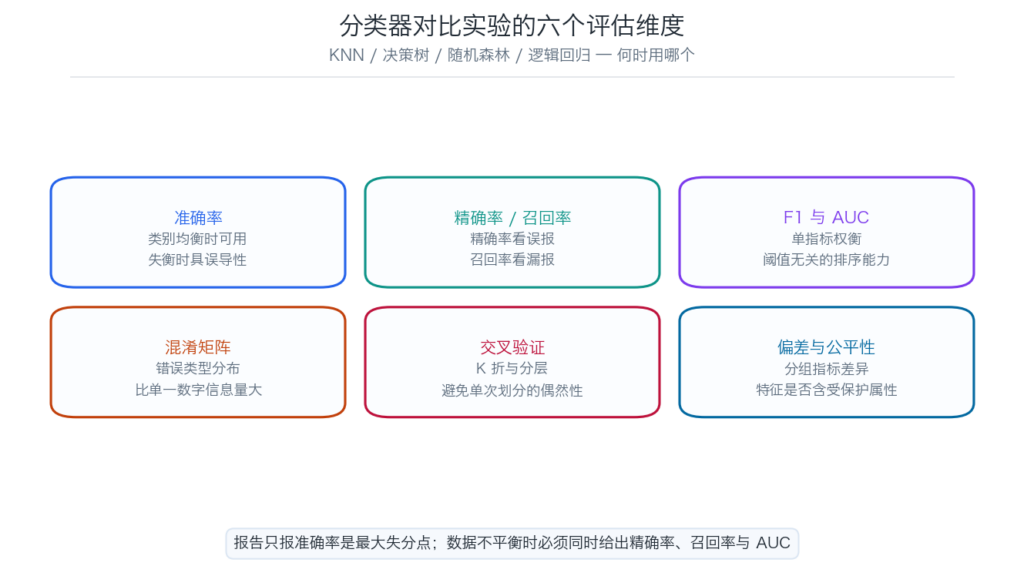
机器学习作业代写 里,分类器对比是最常见的题型,也是最容易只拿到及格分的题型——因为多数人把四个模型跑一遍、贴一张准确率表就交了,而评分重心在「为什么这个模型在这个数据上更好」以及「评估指标选得对不对」。
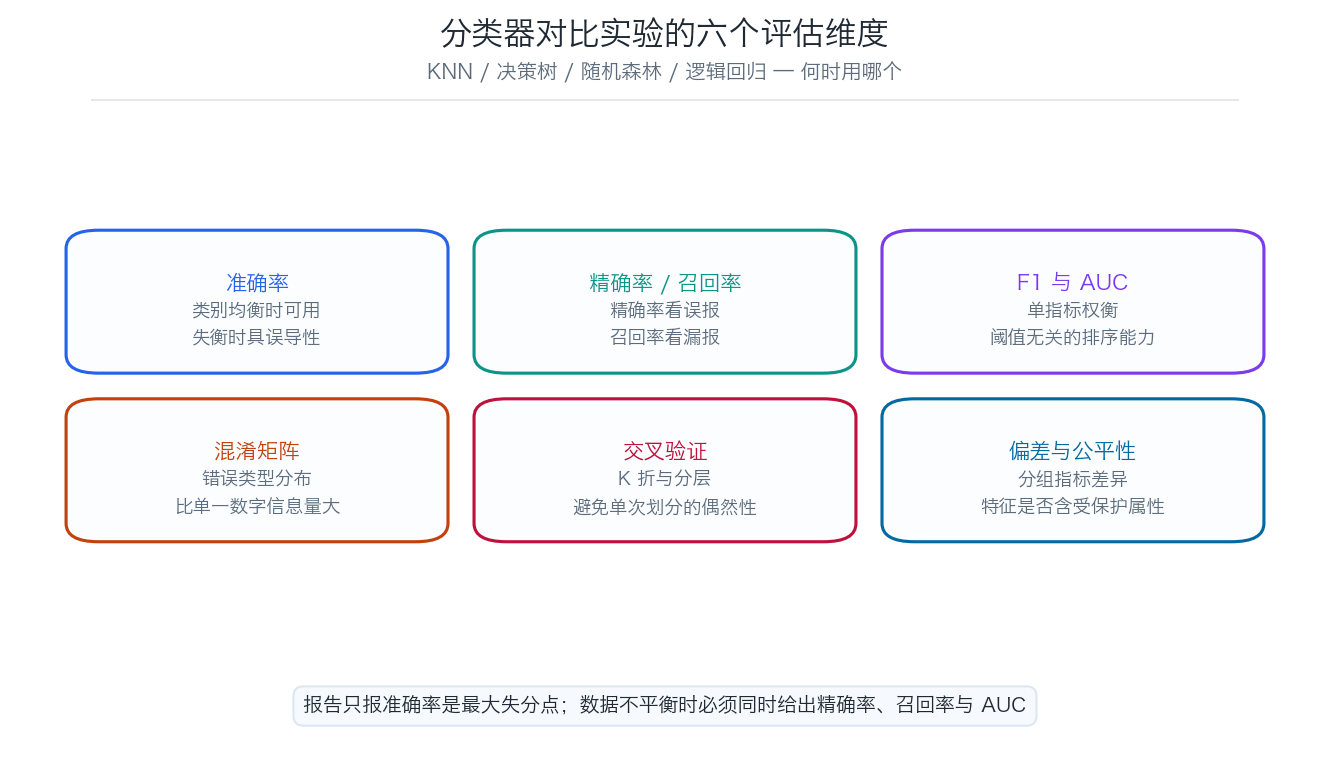
评估指标:准确率为什么常常不够
准确率在类别不均衡时会严重高估模型性能——当负类占 95% 时,一个「永远预测负类」的模型准确率就有 95%。
from sklearn.metrics import (accuracy_score, precision_score, recall_score,
                             f1_score, roc_auc_score, confusion_matrix)

y_pred = model.predict(X_test)
y_prob = model.predict_proba(X_test)[:, 1]

print('准确率 :', accuracy_score(y_test, y_pred))
print('精确率 :', precision_score(y_test, y_pred, zero_division=0))
print('召回率 :', recall_score(y_test, y_pred, zero_division=0))
print('F1     :', f1_score(y_test, y_pred, zero_division=0))
print('AUC    :', roc_auc_score(y_test, y_prob))
print('混淆矩阵:n', confusion_matrix(y_test, y_pred))
四个指标各自的含义要说清:
- 精确率(Precision):预测为正的样本里,真正为正的比例。关心「误报代价」时用它——把正常邮件判成垃圾邮件。
- 召回率(Recall):真正为正的样本里,被找出来的比例。关心「漏报代价」时用它——把生病判成健康。
- F1:两者的调和平均,适用于两者都重要且类别不均衡的场景。
- AUC:与阈值无关的排序能力,反映「正样本得分高于负样本的概率」。
报告里必须说明「为什么选这个指标」,而不是全列一遍。如果业务场景是「筛查」(宁可多报不可漏报),主指标应是召回率;如果是「拦截」(误报会伤害用户),主指标应是精确率。
四个模型的核心差异
四个模型的本质区别在于「决策边界的形状」与「可解释性」——KNN 是局部投票、决策树是轴平行切分、随机森林是多树集成、逻辑回归是线性加权。
KNN(K 近邻)
from sklearn.neighbors import KNeighborsClassifier
from sklearn.preprocessing import StandardScaler

# KNN 对量纲极其敏感,必须先标准化
scaler = StandardScaler()
X_train_s = scaler.fit_transform(X_train)
X_test_s  = scaler.transform(X_test)     # 注意:只用训练集 fit

knn = KNeighborsClassifier(n_neighbors=5)
knn.fit(X_train_s, y_train)特点:无需训练(惰性学习),但预测慢(要算到所有训练样本的距离);必须有标准化,否则量纲大的特征会主导距离;K 太小易过拟合,K 太大欠拟合。
决策树
from sklearn.tree import DecisionTreeClassifier, export_text

tree = DecisionTreeClassifier(max_depth=4, min_samples_leaf=10,
                              random_state=42)
tree.fit(X_train, y_train)
print(export_text(tree, feature_names=list(X.columns))) # 可读的规则特点:可解释性最强(能打印成 if-else 规则);不需要标准化;但单棵树方差大、易过拟合,必须限制深度或用剪枝。
随机森林
from sklearn.ensemble import RandomForestClassifier

rf = RandomForestClassifier(n_estimators=300, max_depth=None,
                            min_samples_leaf=2, n_jobs=-1, random_state=42)
rf.fit(X_train, y_train)

# 特征重要性
for name, imp in sorted(zip(X.columns, rf.feature_importances_),
                        key=lambda x: -x[1])[:10]:
    print(f'{name:24s} {imp:.3f}')
特点:通过「自助采样 + 随机特征子集」降低方差,通常开箱即用表现最好;不需要标准化;但可解释性比单棵树弱很多(特征重要性不等于因果,且对相关特征会互相稀释)。
逻辑回归
from sklearn.linear_model import LogisticRegression

lr = LogisticRegression(max_iter=1000, class_weight='balanced')
lr.fit(X_train_s, y_train)     # 同样建议标准化,便于系数比较

# 系数方向可直接解释
for name, coef in sorted(zip(X.columns, lr.coef_[0]), key=lambda x: -abs(x[1]))[:10]:
print(f'{name:24s} {coef:+.3f}')特点:系数可直接解释为「该特征每增加一个单位,对数几率变化多少」;训练快;但只能拟合线性边界,需要人工构造交互项才能捕捉非线性。
交叉验证:单次划分不可信
单次训练/测试划分的结果受随机种子影响很大,K 折交叉验证通过多次划分给出均值和方差,才谈得上「模型 A 优于模型 B」。
from sklearn.model_selection import StratifiedKFold, cross_val_score

cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
for name, model in [('KNN', knn), ('Tree', tree), ('RF', rf), ('LR', lr)]:
    scores = cross_val_score(model, X_train_s, y_train, cv=cv,
                             scoring='roc_auc')
    print(f'{name:6s} AUC = {scores.mean():.4f} ± {scores.std():.4f}')
必须用分层(Stratified)而非普通 K 折——分层保证每折的正负比例与整体一致,类别不均衡时尤其重要。报告里要报「均值 ± 标准差」,只报均值无法判断差异是否显著。
超参数调优:别在测试集上调
from sklearn.model_selection import GridSearchCV

param_grid = {'n_neighbors': [3, 5, 7, 11, 15]}
gs = GridSearchCV(KNeighborsClassifier(), param_grid, cv=cv,
                  scoring='f1', n_jobs=-1)
gs.fit(X_train_s, y_train)
print('最优 K:', gs.best_params_, ' 交叉验证 F1:', gs.best_score_)调参必须在训练集内部做(用交叉验证),测试集只在最后评估一次。如果用测试集选超参数,报告的指标会虚高,属于方法性错误。
偏差与公平性:报告里该有的一节
模型整体指标好,不代表对每个子群体都好——分组评估是发现系统性偏差的必要步骤。
# 按受保护属性分组,比较各组的召回率
for group in df_test['group'].unique():
    mask = df_test['group'] == group
    r = recall_score(y_test[mask], y_pred[mask], zero_division=0)
print(f'{group:12s} 样本数={mask.sum():5d} 召回率={r:.3f}')如果某组召回率显著低于其它组,说明模型对该群体系统性失效。报告里应该讨论三点:差异有多大、可能的原因(训练样本不足?特征本身有偏?)、以及缓解方向(重采样、去掉受保护属性、分组阈值)。
常见扣分点
- 只报准确率,类别不均衡时不报精确率/召回率/AUC。
- KNN 或逻辑回归没做标准化(或先标准化再划分,造成数据泄漏)。
- 用测试集调超参数。
- 只做单次划分,没有交叉验证或没有报标准差。
- 交叉验证用普通 K 折而非分层。
- 混淆矩阵只贴图不解读(哪些类互相混淆、为什么)。
- 把特征重要性解释为因果关系。
- 缺少分组公平性讨论。
- 决策树不限制深度,训练集 100% 测试集很差却不分析。
常见问题
四个模型里应该选哪个?
看数据规模和可解释性要求。小数据、需要解释给非技术受众 → 逻辑回归或浅层决策树;中等数据、追求准确率 → 随机森林;样本量很大且特征维度高 → KNN 会变慢,不合适。报告里应该给出选择理由,而不是「随机森林最好所以选它」。
标准化应该在哪一步做?
用训练集 fit,用同一个 scaler 去 transform 测试集。如果先对全量数据标准化再划分,测试集的均值方差信息就泄漏进了训练过程,评估结果虚高。这个错误很常见,作业里会被专门检查。
AUC 0.85 算好吗?
取决于领域。信用评分、欺诈检测里 0.85 已经不错;医学影像里 0.85 可能偏低。判断标准是与基线对比:随机猜测是 0.5,简单规则(比如只用最相关的一个特征)能到多少?报告里给出基线才有参照。
类别不均衡怎么处理?
三条路径:重采样(对少数类过采样 SMOTE,或对多数类欠采样)、类别权重(class_weight='balanced')、调整判定阈值(不用 0.5,按业务需求选)。重采样只能在训练集内做,在划分前做会污染测试集。
特征重要性可以说明因果吗?
不能。特征重要性只反映「这个特征对预测有用」,可能因为它与真实原因相关(混淆变量),也可能因为模型利用了数据中的偏差。要讨论因果需要实验设计或因果推断方法,不是分类模型的产出。
报告需要画决策边界吗?
如果特征只有两个维度,画决策边界非常直观,能一眼看出线性 vs 非线性的差异。高维数据可以先用 PCA 降到二维再画,但要注明「这是投影,可能失真」。这项不是必需,但做了是加分点。
代写Pro 的机器学习作业服务
- 指标选得对:按业务场景说明主指标选择理由,不只报准确率。
- 流程无泄漏:标准化、重采样、调参全部在训练集内完成。
- 对比有统计意义:分层交叉验证,报均值 ± 标准差。
- 解释到位:混淆矩阵解读、特征重要性的正确表述、分组公平性讨论。
- 可复现:固定随机种子,Notebook 含完整流程与依赖声明。